Eine KI-Idee kann bereits erstaunlich konkret wirken. Der Anwendungsfall ist beschrieben, erste Datenquellen sind bekannt und vielleicht gibt es sogar schon eine Vorstellung davon, welches Modell oder welche technische Lösung eingesetzt werden könnte.
Trotzdem kann eine entscheidende Lücke offenbleiben: Was soll sich durch das Vorhaben tatsächlich verbessern?
Im ersten Beitrag dieser Reihe ging es darum, wann aus einer KI-Idee überhaupt ein belastbar beschriebenes Vorhaben wird. Der nächste Schritt führt tiefer. Bei entscheidungsbezogenen KI- und Datenanwendungen sollte nachvollziehbar sein, welche Entscheidung oder Handlung durch den Systemoutput verändert werden soll und woran sich eine Verbesserung erkennen lässt.
Diese Logik passt nicht unverändert auf jedes KI-Vorhaben. Ein generatives System kann beispielsweise primär einen Textentwurf, Code oder ein anderes Arbeitsergebnis erzeugen. Dieser Beitrag konzentriert sich deshalb auf Anwendungen, bei denen ein wesentlicher Teil des Nutzens daraus entsteht, was Menschen oder Systeme anschließend mit einem Modelloutput tun.
Ein fiktiver Fall aus der Produktion
Nehmen wir einen ausdrücklich fiktiven mittelständischen Hersteller von Präzisionsbauteilen für industrielle Antriebssysteme, den wir hier Nordwerk nennen. Unternehmen, Maschinenhistorie und sämtliche Zahlen des Beispiels sind frei erfunden.
Bei Nordwerk arbeiten rund 250 Beschäftigte. In einem Produktionsbereich laufen mehrere fünfachsige CNC-Bearbeitungszentren im Dreischichtbetrieb. Bearbeitungszentrum 4 übernimmt Bearbeitungsschritte, die bei einem ungeplanten Stillstand kurzfristig nur begrenzt auf andere Maschinen verlagert werden können.
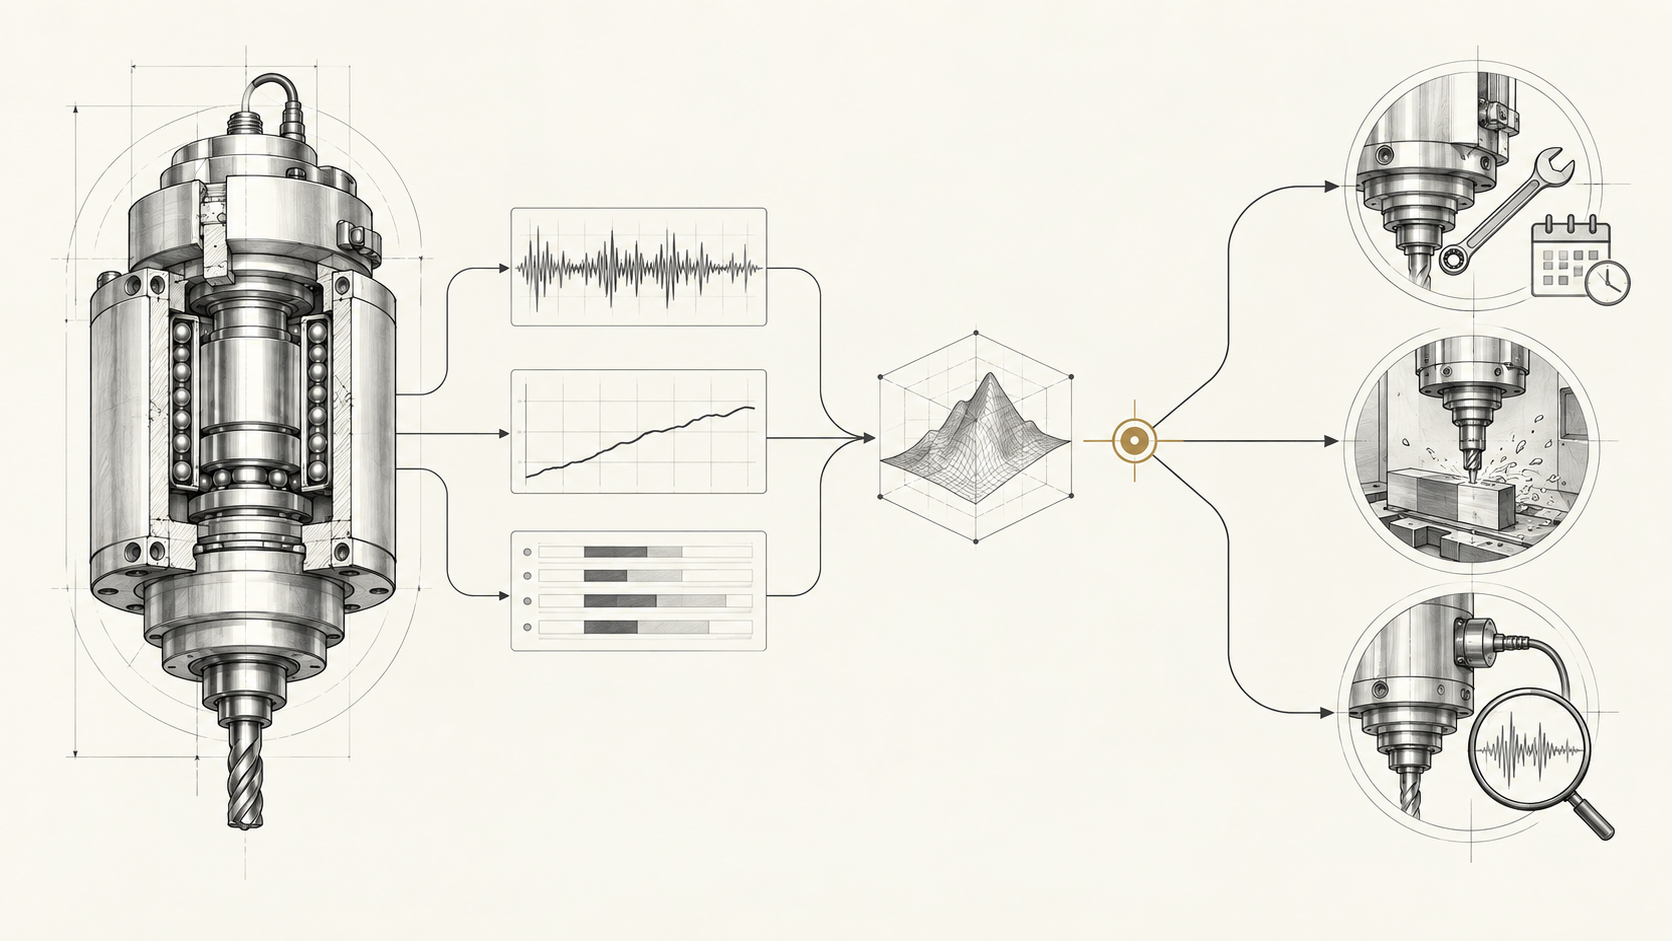
An dieser Maschine sind in der Vergangenheit wiederholt ungeplante Schäden an den Lagern der Frässpindel aufgetreten. Verschlechtert sich ihr Zustand unbemerkt, kann die Maschine schließlich ausfallen; abhängig vom konkreten Schadensbild müssen laufende Bauteile zusätzlich geprüft, Produktionspläne angepasst und Wartungsmaßnahmen kurzfristig organisiert werden.
Heute arbeitet Nordwerk mit festen Wartungsintervallen, Maschinenmeldungen und der Erfahrung der Instandhaltung. Nun soll geprüft werden, ob sich Vibrations- und Temperaturdaten, Spindelbelastung, Betriebsstunden und Wartungshistorien nutzen lassen, um mit Machine Learning ein erhöhtes Ausfallrisiko einige Tage im Voraus zu erkennen.
Für das Gedankenexperiment springen wir einen Schritt weiter: Das Modell ist entwickelt und meldet Montagmorgen für Bearbeitungszentrum 4 ein Ausfallrisiko von 72 Prozent innerhalb der kommenden sieben Tage. Die reguläre Wartung wäre erst in drei Wochen vorgesehen.
Was würden Sie tun: die Wartung vorziehen, weiterproduzieren oder zunächst zusätzliche Prüfungen veranlassen?
Behalten Sie Ihre erste Entscheidung zunächst im Kopf, denn wir kommen später darauf zurück.
Kurzfassung für Entscheider
Für Leser mit wenig Zeit: die Kernaussagen dieses Beitrags in kompakter Form.
Kernaussage
Bei entscheidungsbezogenen KI- und Datenvorhaben endet die Nutzenlogik nicht beim Systemoutput. Relevant ist, wer das Ergebnis verwendet, welche Entscheidung oder Handlung sich dadurch verändert und welche Folgen daraus entstehen.
Stärkste Evidenz
Forschung zu Predict-then-Optimize-Problemen trennt ausdrücklich zwischen Vorhersagefehler und dem Fehler der daraus abgeleiteten Entscheidung; NIST behandelt Einsatzkontext, Nutzer, Alternativen und nachgelagerte Entscheidungen als relevante Prüfaspekte. [1] [2]
Größte Unsicherheit
Eine gute Modellmetrik sagt noch nicht automatisch, ob die nachgelagerte fachliche oder wirtschaftliche Entscheidung besser wird. Dafür müssen Konsequenzen, Alternativen und der Vergleichsmaßstab geklärt werden.
Praktische Konsequenz
Ein belastbarer Use Case sollte erklären können, wie der Weg vom Modelloutput bis zur fachlichen oder wirtschaftlichen Wirkung aussieht und gegen welchen Vergleichsmaßstab diese Wirkung beurteilt wird.
Eine Prognose ist noch keine Entscheidung
Im Nordwerk-Beispiel scheint das technische Ziel zunächst klar: drohende Schäden an der Frässpindel früher erkennen.
Daraus lässt sich ein Prognoseproblem formulieren. Das Modell verarbeitet Zustands- und Betriebsdaten und liefert eine Einschätzung darüber, wie wahrscheinlich ein bestimmtes Ereignis innerhalb eines definierten Zeitraums ist.
Die betriebliche Nutzung beginnt mit der Frage, was aus dieser Information folgen soll. Soll die Maschine aus der Produktion genommen werden? Soll die Instandhaltung zunächst zusätzliche Schwingungsmessungen durchführen? Wird lediglich ein Ersatzteil vorbereitet? Reicht eine engmaschigere Beobachtung? Und wer darf unter welchen Bedingungen die jeweilige Entscheidung treffen?
Genau diese Trennung findet sich auch in der Forschung. Elmachtoub und Grigas unterscheiden in Smart “Predict, then Optimize” zwischen dem Fehler einer Vorhersage und dem Fehler der daraus abgeleiteten Entscheidung. Ihr Framework bezieht sich auf nachgelagerte Optimierungsprobleme und ist damit kein allgemeines Modell für jedes KI-Projekt; die Arbeit zeigt aber sehr klar, warum die Optimierung einer Prognosemetrik und die Optimierung einer späteren Entscheidung unterschiedliche Bewertungsfragen sein können. [1]
Für Nordwerk folgt daraus zunächst eine nüchterne Konsequenz: Selbst ein Modell, das Maschinenzustände technisch gut klassifiziert, belegt damit noch nicht, dass Wartungszeitpunkte, Diagnosemaßnahmen oder Produktionsentscheidungen unter realen Bedingungen besser werden.
Fünf Fragen zwischen Modelloutput und Wirkung
Für diese Verbindung ist eine einfache Prüfkette hilfreich. Sie ist kein externer Standard, sondern eine eigene Synthese für die Vorhabenklärung:
- Output: Was liefert das System tatsächlich?
- Nutzung: Wer verwendet dieses Ergebnis – und in welcher Situation?
- Veränderung: Welche Entscheidung, Handlung oder Arbeitsleistung soll sich dadurch verändern?
- Konsequenz: Welche positiven und negativen Folgen können aus den möglichen Reaktionen entstehen?
- Maßstab: Woran erkennen wir, dass die Veränderung gegenüber dem heutigen Zustand oder einer realistischen Alternative tatsächlich besser ist?
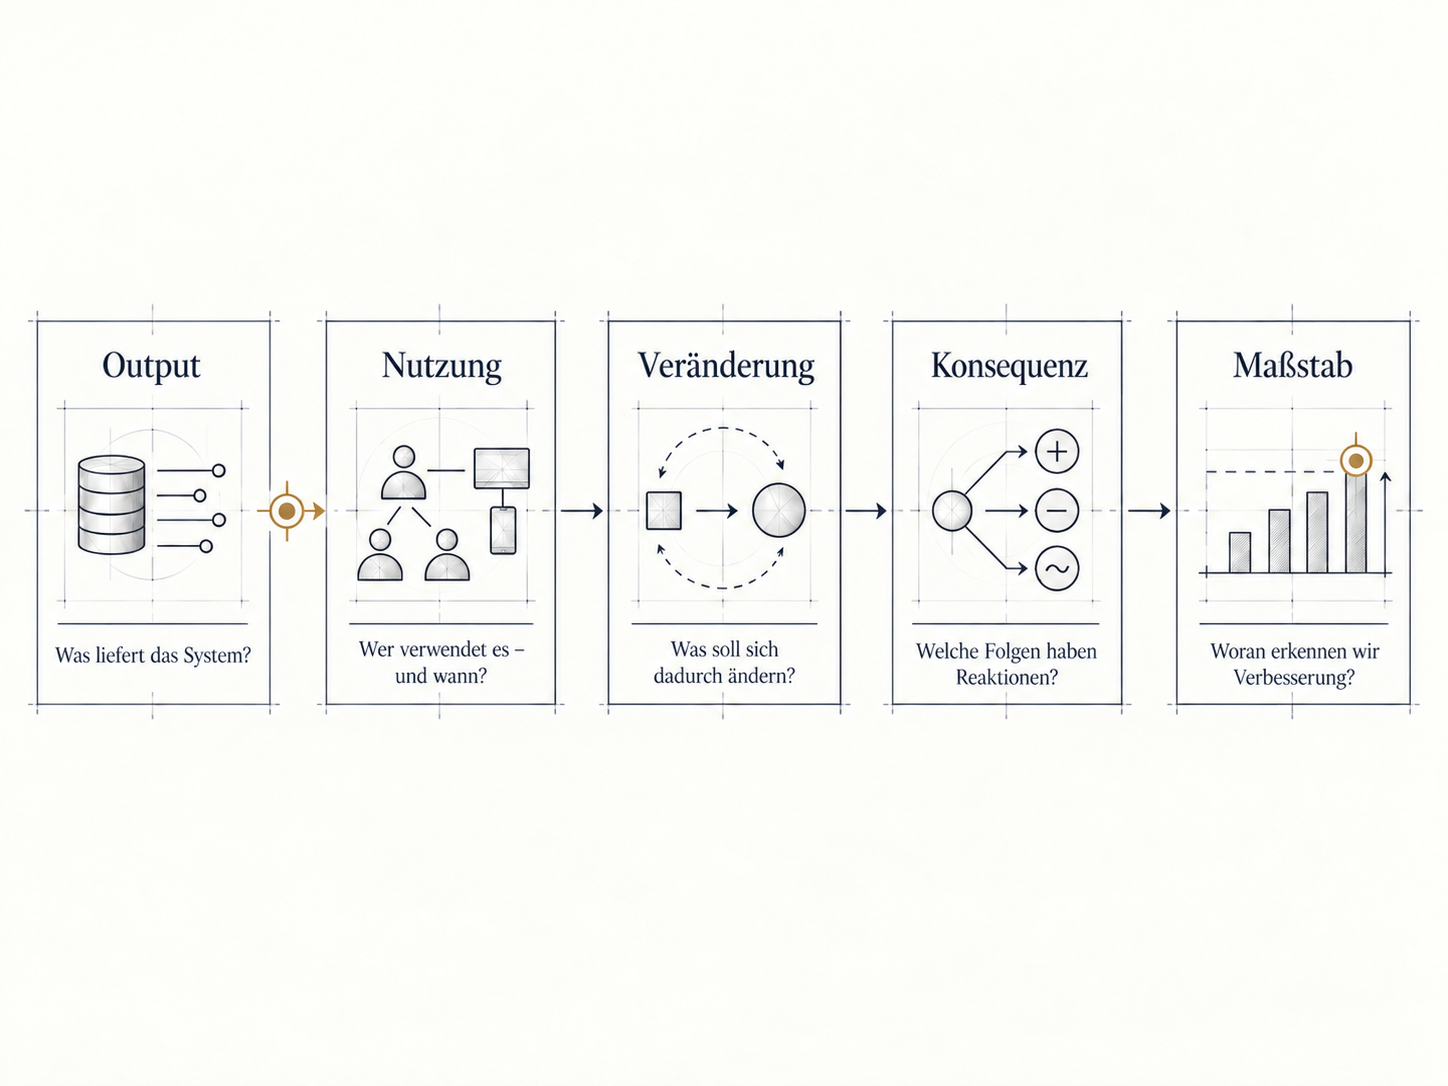
Beim Nordwerk-Beispiel wäre der unmittelbare Output zunächst lediglich eine Risikoeinschätzung. Fachlicher oder wirtschaftlicher Nutzen kann daraus entstehen, wenn diese Information zu einer sinnvolleren Diagnose-, Wartungs- oder Produktionsentscheidung beiträgt.
Im AI Risk Management Framework und dem zugehörigen Playbook des National Institute of Standards and Technology (NIST) werden Einsatzkontext, Nutzer, Auswirkungen und Alternativen ausdrücklich als Prüfaspekte behandelt. Das Playbook empfiehlt unter anderem zu untersuchen, wie Änderungen der Systemleistung nachgelagerte Entscheidungen beeinflussen und ob Nicht-KI- oder Nicht-Technologie-Alternativen geeigneter sein könnten. [2]
Beim fünften Punkt entsteht allerdings ein methodisches Problem, das leicht übersehen wird: Nach einer konkreten Entscheidung beobachten wir nur den tatsächlich eingeschlagenen Weg. Wird die Maschine vorsorglich gewartet und fällt anschließend nicht aus, können wir an diesem Einzelfall nicht gleichzeitig beobachten, ob sie ohne Wartung ebenfalls weitergelaufen oder tatsächlich ausgefallen wäre. Diese fehlende Beobachtbarkeit des alternativen Verlaufs ist ein Grundproblem kausaler Inferenz. [6]
Für die Bewertung eines KI-Vorhabens bedeutet das nicht, dass Wirkung grundsätzlich nicht messbar wäre. Es bedeutet vielmehr, dass „besser“ einen belastbaren Vergleichsaufbau benötigt und ein einzelnes positives Ergebnis noch keine kausale Wirkung belegt. Wie sich solche Vergleichs- und Wirkungsmessungen sinnvoll aufbauen lassen, verdient später eine eigene Vertiefung.
Wenn die Modellmetrik das Projektziel verdrängt
Zu Beginn könnte Nordwerks fachliches Ziel lauten:
Ungeplante spindelbedingte Maschinenstillstände sinnvoll reduzieren.
Mit zunehmender technischer Konkretisierung treten andere Größen in den Vordergrund: beispielsweise Precision, Recall, Fehlerraten oder weitere für das konkrete Modell geeignete Metriken. Diese technische Bewertung ist notwendig, denn ohne sie lässt sich kaum feststellen, ob das Modell überhaupt brauchbare Informationen liefert.
Ein Risiko entsteht, wenn sich das Projektziel währenddessen unbemerkt verschiebt und die Optimierung einer Modellmetrik an die Stelle der ursprünglich angestrebten betrieblichen Verbesserung tritt.
Ein niedrigerer Warnschwellenwert könnte beispielsweise dazu führen, dass mehr bevorstehende Schäden erkannt werden. Gleichzeitig könnten mehr Warnungen für Maschinenzustände entstehen, die keinen kurzfristigen Eingriff erfordert hätten. Ein zurückhaltenderes System würde möglicherweise weniger unnötige Prüfungen auslösen, könnte dafür aber relevante Schäden übersehen.
Welche Variante vorzuziehen ist, hängt deshalb auch von den Folgen unterschiedlicher Fehlentscheidungen ab. Charles Elkan zeigt in seiner grundlegenden Arbeit zu Cost-Sensitive Learning, dass verschiedene Fehlklassifikationen unterschiedliche Konsequenzen besitzen können und Entscheidungen entsprechend an diesen Konsequenzen ausgerichtet werden sollten; solche „Kosten“ müssen dabei nicht ausschließlich monetär sein. [3]
Für unser Beispiel heißt das: Ein unnötiger Wartungseingriff und ein übersehener bevorstehender Lagerschaden können völlig unterschiedliche Auswirkungen haben. Wie sich solche Fehlerkosten systematisch bewerten lassen und welchen Einfluss sie auf Entscheidungsschwellen haben, ist wichtig genug für einen eigenen Beitrag und wird hier bewusst nicht vorweggenommen.
Für diesen Beitrag reicht zunächst die Verbindung zwischen technischer Modellgüte und betrieblicher Entscheidungsqualität. Dadurch wird aus „Wie gut ist unser Modell?“ eine konkretere Projektfrage:
Welche Modellleistung benötigen wir, damit die damit unterstützten Entscheidungen unter unseren tatsächlichen Betriebsbedingungen einen relevanten Vorteil erzeugen?
Was ich aus eigenen ML-Projekten mitgenommen habe
Aus meiner bisherigen Arbeit an Machine-Learning-Klassifikationsprojekten kenne ich diese Schnittstelle als einen kritischen Punkt. Neben der Modellgüte muss früh geklärt werden, wie Anwender und Entscheider mit dem Ergebnis tatsächlich arbeiten sollen.
Ich habe es als besonders wichtig erlebt, die späteren Nutzer bereits in die Entwicklung einzubeziehen. Erwartungen, praktische Entscheidungswege und Grenzen des Modells werden dadurch früher sichtbar und können adressiert werden, bevor sich eine technisch plausible Lösung bereits weitgehend verfestigt hat.
Bei Nordwerk wären insbesondere diejenigen Personen aus Instandhaltung und Produktion einzubeziehen, die später aus einer Warnung konkrete Maßnahmen ableiten sollen. Für sie ist die Zahl „72 Prozent“ nur ein Teil der benötigten Information. Ebenso relevant sind zusätzliche Diagnosemöglichkeiten, verfügbare Wartungsfenster, Konsequenzen eines Eingriffs und die bekannten Grenzen des Modells.
Wie stark Partizipation, Fähigkeiten, Handlungsspielraum, Vertrauen und Verantwortlichkeit die Qualität KI-unterstützter Entscheidungen beeinflussen, geht über die Fragestellung dieses Beitrags hinaus. Genau diese menschliche Seite der Entscheidungsarchitektur verdient eine eigene Vertiefung.
Wo die Entscheidungsfrage verzerrt werden kann
Die bisherige Logik kann an mehreren Stellen kippen. Dabei wirken kognitive Verzerrungen, methodische Risiken und organisatorische Lücken häufig zusammen.
Lösungsanker: Beginnt ein Vorhaben bereits mit „Wir brauchen Predictive Maintenance mit Machine Learning“, kann die gewünschte Technologie die weitere Problemdefinition prägen. Eine einfache Gegenprobe besteht darin, „KI“ und „Machine Learning“ gedanklich aus dem Projektauftrag zu streichen und zu prüfen, ob Problem und gewünschte Verbesserung anschließend noch genauso beschrieben würden.
Zielverschiebung durch Metriken: Technische Zielgrößen sind häufig leichter messbar als betriebliche Wirkung. Dadurch kann sich die Aufmerksamkeit schrittweise von der gewünschten Verbesserung zur nächsten Modelloptimierung verlagern. Eine regelmäßige Rückbindung an die ursprüngliche Entscheidungs- und Wirkungslogik reduziert dieses Risiko.
Automation Bias: Ein präzise wirkender Modelloutput kann mehr Autorität entfalten, als seine Aussagekraft rechtfertigt. Der EU AI Act greift dieses Risiko ausdrücklich für Hochrisiko-KI-Systeme auf und verlangt dort unter anderem, dass zuständige Personen sich der möglichen Tendenz zum automatischen oder übermäßigen Vertrauen in Systemoutputs bewusst bleiben und die Ergebnisse korrekt interpretieren können. Diese regulatorische Vorgabe lässt sich nicht pauschal auf unser fiktives industrielles System übertragen, verdeutlicht aber das grundsätzliche Risiko in entscheidungsunterstützenden Anwendungen. [4]
Verantwortungs- und Handlungslücke: Technisch kann klar definiert sein, was ein System ausgibt, während organisatorisch offen bleibt, wer daraus welche Handlung ableiten darf. Gerade bei Unsicherheit muss geklärt werden, wer zusätzliche Diagnosen anordnet, wer einen Produktionsstopp freigibt und welche Informationen dafür benötigt werden.
Diese Risiken machen die Entscheidungsfrage zu mehr als einer Formalität, weil sie technische, menschliche und organisatorische Teile eines Vorhabens früh miteinander verbindet.
Vielleicht braucht Nordwerk dafür gar kein Machine Learning
Sobald die gewünschte Veränderung sichtbar ist, lässt sich auch die Technologie nüchterner bewerten.
Möglicherweise liefern bestehende Zustandsgrenzen der Maschinenüberwachung bereits einen erheblichen Teil des benötigten Nutzens. Denkbar wäre auch ein standardisierter Diagnoseablauf oder eine einfache Kombination aus Schwingungswerten, Betriebsstunden und Wartungshistorie. Ob eine dieser Varianten Nordwerks fiktives Problem tatsächlich besser lösen würde, lässt sich ohne reale Daten bewusst nicht beantworten.
Die Alternativen sollten dennoch Teil der Bewertung sein. Googles öffentlich dokumentierte Rules of Machine Learning behandeln einfache Heuristiken ausdrücklich als legitimen Ausgangspunkt. Der Leitfaden empfiehlt, ein Produkt gegebenenfalls zunächst ohne Machine Learning aufzubauen; wenn regelbasierte Heuristiken später selbst zunehmend komplex werden, kann Machine Learning wiederum die sinnvollere Richtung sein. [5]
Diese Praxisperspektive deckt sich an dieser Stelle mit dem NIST Playbook, das ebenfalls empfiehlt, geeignete Nicht-KI- oder Nicht-Technologie-Alternativen in die Kontextanalyse einzubeziehen. [2]
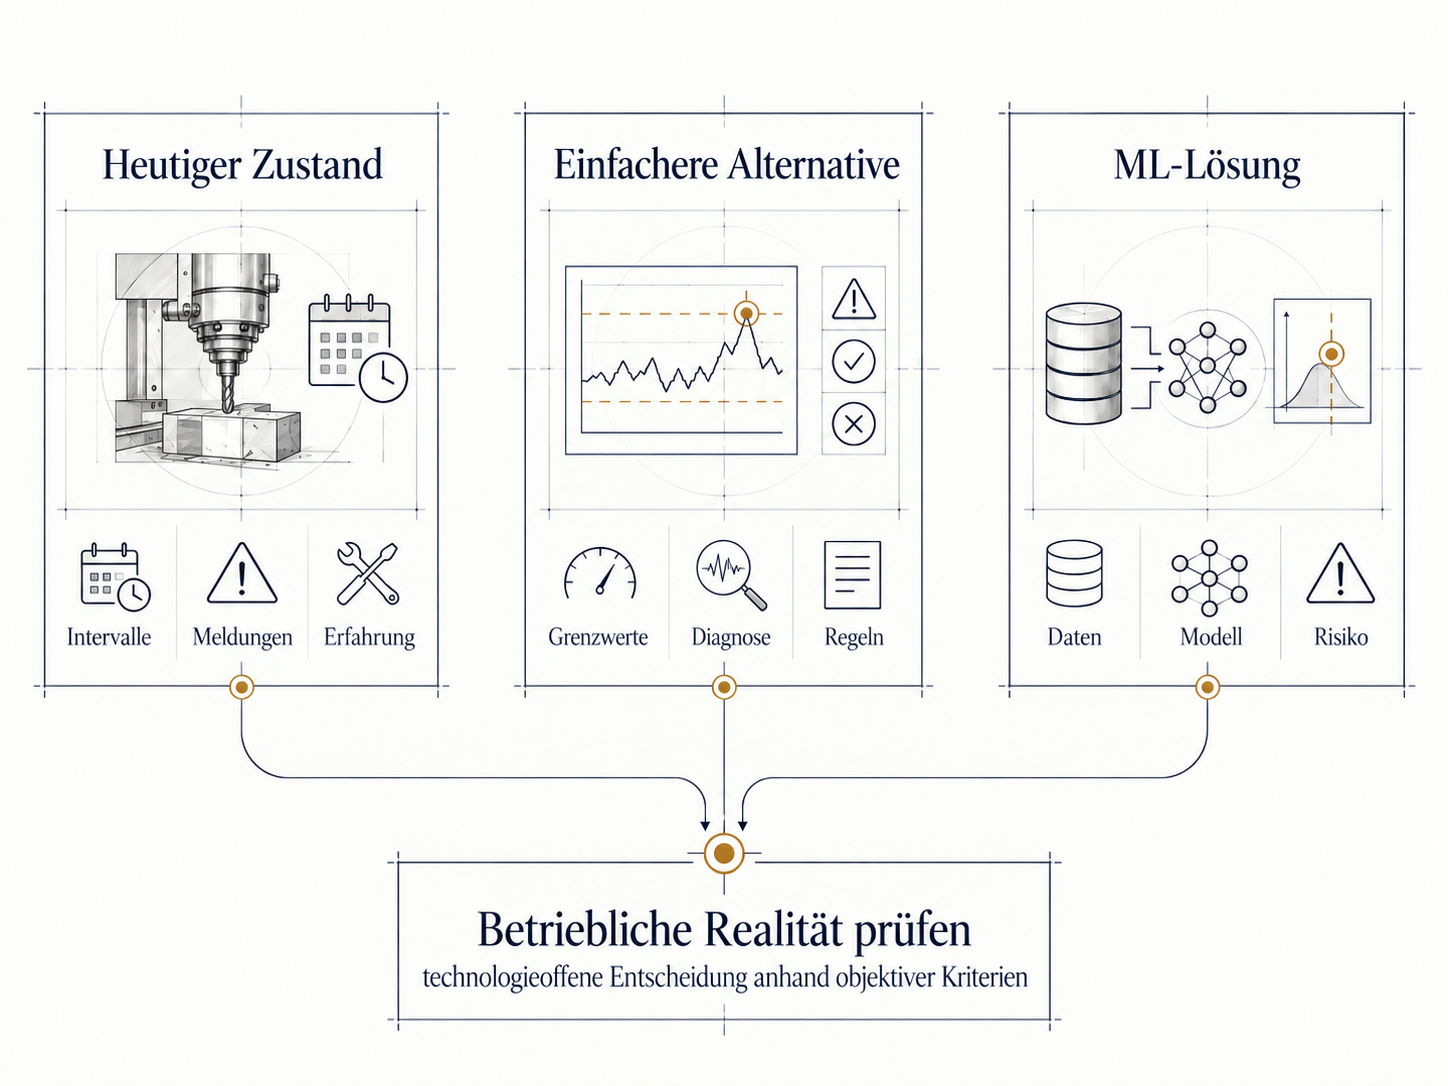
Eine faire Bewertung verwendet deshalb den heutigen Zustand und die sinnvollsten realistischen Alternativen als Vergleichsbasis für die geplante KI-Lösung. Erst dieser Vergleich zeigt, welchen zusätzlichen Beitrag die technische Komplexität tatsächlich leisten müsste.
Zurück zu den 72 Prozent
Wie sollte Nordwerk nun mit Bearbeitungszentrum 4 umgehen: Wartung vorziehen, weiterproduzieren oder zunächst zusätzliche Prüfungen durchführen?
Die Analyse liefert bewusst keine universell richtige Auswahl aus diesen drei Optionen. Sie zeigt aber, wovon ihre Bewertung abhängt.
Eine vorgezogene Wartung könnte plausibel sein, wenn der Modelloutput unter vergleichbaren Bedingungen ausreichend belastbar ist, die Folgen eines übersehenen Schadens schwer wiegen und ein geplanter Eingriff gegenüber einem ungeplanten Ausfall vertretbar erscheint.
Weiterproduzieren könnte sinnvoll sein, wenn die Warnung noch erhebliche Unsicherheit enthält, der Maschinenzustand eng überwacht werden kann und ein sofortiger Eingriff hohe Nachteile verursacht.
Eine zusätzliche Diagnose gewinnt besonders dann an Wert, wenn sie innerhalb der verfügbaren Zeit relevante Unsicherheit reduzieren kann und dadurch eine fundiertere Entscheidung zwischen Eingriff und Weiterbetrieb ermöglicht.
Keine dieser Bedingungen ist in unserem Gedankenexperiment ausreichend beschrieben. Genau deshalb reicht die Angabe „72 Prozent Ausfallrisiko“ allein nicht für eine belastbare Entscheidung.
Für eine begründete Auswahl müssten beispielsweise die Zuverlässigkeit des Outputs unter vergleichbaren Betriebsbedingungen, die Konsequenzen eines übersehenen Spindellagerschadens, der Aufwand eines unnötigen Wartungseingriffs, verfügbare Diagnosemöglichkeiten und der konkrete Handlungsspielraum von Produktion und Instandhaltung berücksichtigt werden.
Auch die Zahl selbst benötigt eine klare Bedeutung. Vor einer solchen Nutzung müsste geklärt werden, was die 72 Prozent technisch genau repräsentieren und wie zuverlässig diese Größe unter vergleichbaren Betriebsbedingungen interpretiert werden kann. Die tiefergehende Frage nach Kalibrierung und geeigneten Modellmetriken gehört allerdings in eine eigene Modellbewertung und soll hier nicht vorweggenommen werden.
Vielleicht ist Ihre erste Entscheidung damit unverändert geblieben. Der Unterschied liegt darin, dass sie sich jetzt an konkrete Voraussetzungen knüpfen lässt, die geprüft werden können.
Damit lässt sich auch die ursprüngliche Projektbeschreibung präzisieren. Aus der Idee
„Wir wollen Spindelschäden mit Machine Learning vorhersagen.“
könnte beispielsweise die belastbarere Zielrichtung entstehen:
„Wir wollen drohende spindelbedingte Ausfälle früh genug erkennen, damit Instandhaltung und Produktion zwischen Weiterbetrieb, zusätzlicher Diagnose und vorgezogener Wartung belastbarer entscheiden können.“
Diese Formulierung schafft noch keinen Business Case und keine vollständige Projektdefinition. Sie macht aber sichtbar, welche Informationen und Daten jetzt benötigt werden, welche Fehlentscheidungen besonders kritisch sind und welchen zusätzlichen Nutzen eine ML-Lösung gegenüber einer einfacheren Alternative liefern müsste.
Das Modell bleibt damit ein zentraler technischer Bestandteil und wird zugleich in die Entscheidungslogik eingebettet, für die es überhaupt entwickelt werden soll.
Was vor der nächsten technischen Frage klar sein sollte
Für entscheidungsbezogene KI- und Datenvorhaben lässt sich die Prüfkette kompakt verdichten:
Output → Nutzung → Veränderung → Konsequenz → Maßstab
Ein Vorhaben muss zu Beginn nicht jede dieser Fragen abschließend beantworten. Gerade frühe Exploration kann sinnvoll sein, um zunächst herauszufinden, ob Daten ein relevantes Signal enthalten oder welche Lösungsrichtung tragfähig sein könnte.
Wichtig ist, dass offene Punkte auch als offene Punkte sichtbar bleiben. Ein technisch interessantes Ergebnis erhält seinen Projektwert erst durch die Verbindung zu einer relevanten Nutzung und deren Konsequenzen.
Sobald klarer ist, welche Entscheidung oder Handlung verbessert werden soll, führt der nächste Schritt direkt zu einer weiteren Grundlagenfrage: Sind die vorhandenen Daten dafür überhaupt brauchbar?
Entscheidungsübersicht
Kernaussage
Bei entscheidungsbezogenen KI- und Datenvorhaben endet die Nutzenlogik nicht beim Systemoutput. Relevant ist, wer das Ergebnis verwendet, welche Entscheidung oder Handlung sich dadurch verändert und welche Folgen daraus entstehen.
Stärkste Evidenz
Forschung zu Predict-then-Optimize-Problemen trennt zwischen Vorhersagefehler und dem Fehler der daraus abgeleiteten Entscheidung; NIST behandelt Einsatzkontext, Nutzer, Alternativen und nachgelagerte Entscheidungen als relevante Prüfaspekte. [1] [2]
Größte Unsicherheit
Eine gute Modellmetrik sagt noch nicht automatisch, ob die nachgelagerte fachliche oder wirtschaftliche Entscheidung besser wird. Dafür müssen Konsequenzen, Alternativen und der Vergleichsmaßstab geklärt werden.
Praktische Konsequenz
Ein belastbarer Use Case sollte erklären können, wie der Weg vom Modelloutput bis zur fachlichen oder wirtschaftlichen Wirkung aussieht und gegen welchen Vergleichsmaßstab diese Wirkung beurteilt wird.
Quellen
- [1] Adam N. Elmachtoub, Paul Grigas – Smart “Predict, then Optimize”. Management Science 68(1), 2022, S. 9–26. Für die inhaltliche Prüfung wurde zusätzlich die vollständige Autorenfassung auf arXiv, Version 5 vom 19.11.2020, verwendet. Übertragungsgrenze: Das Paper behandelt Predict-then-Optimize-Probleme mit mathematischer Optimierung und wird hier nicht als allgemeines Framework für sämtliche KI-Projekte verwendet. Journalreferenz · Autorenfassung
- [2] National Institute of Standards and Technology – AI Risk Management Framework Playbook, MAP. Relevant für Einsatzkontext, Nutzer, Auswirkungen, Human-AI-Konfiguration, nachgelagerte Entscheidungen sowie Nicht-KI- und Nicht-Technologie-Alternativen. NIST überarbeitet derzeit AI RMF 1.0; das Playbook soll anschließend ebenfalls aktualisiert werden. Quelle
- [3] Charles Elkan – The Foundations of Cost-Sensitive Learning. IJCAI 2001, S. 973–978. Grundlagenquelle zu unterschiedlichen Kosten beziehungsweise Konsequenzen von Fehlklassifikationen; Kosten müssen nicht ausschließlich monetär sein. Volltext
- [4] Europäische Union – Verordnung (EU) 2024/1689, Artikel 14: Human Oversight. Relevant für den Hinweis auf Automation Bias bei Hochrisiko-KI-Systemen. Der Beitrag behauptet nicht, dass das fiktive Nordwerk-System selbst als Hochrisiko-KI einzustufen wäre. EUR-Lex
- [5] Martin Zinkevich / Google – Rules of Machine Learning: Best Practices for ML Engineering. Praxisleitfaden zu einfachen Heuristiken, Baselines und zur Frage, wann zusätzliche ML-Komplexität sinnvoll wird. Kein allgemeingültiger wissenschaftlicher Standard. Quelle
- [6] Paul W. Holland – Statistics and Causal Inference. Journal of the American Statistical Association 81(396), 1986, S. 945–960. Grundlagenquelle zum kontrafaktischen Problem kausaler Inferenz: Für dieselbe Einheit lassen sich die Ergebnisse unter Behandlung und Nicht-Behandlung nicht gleichzeitig beobachten. Quelle