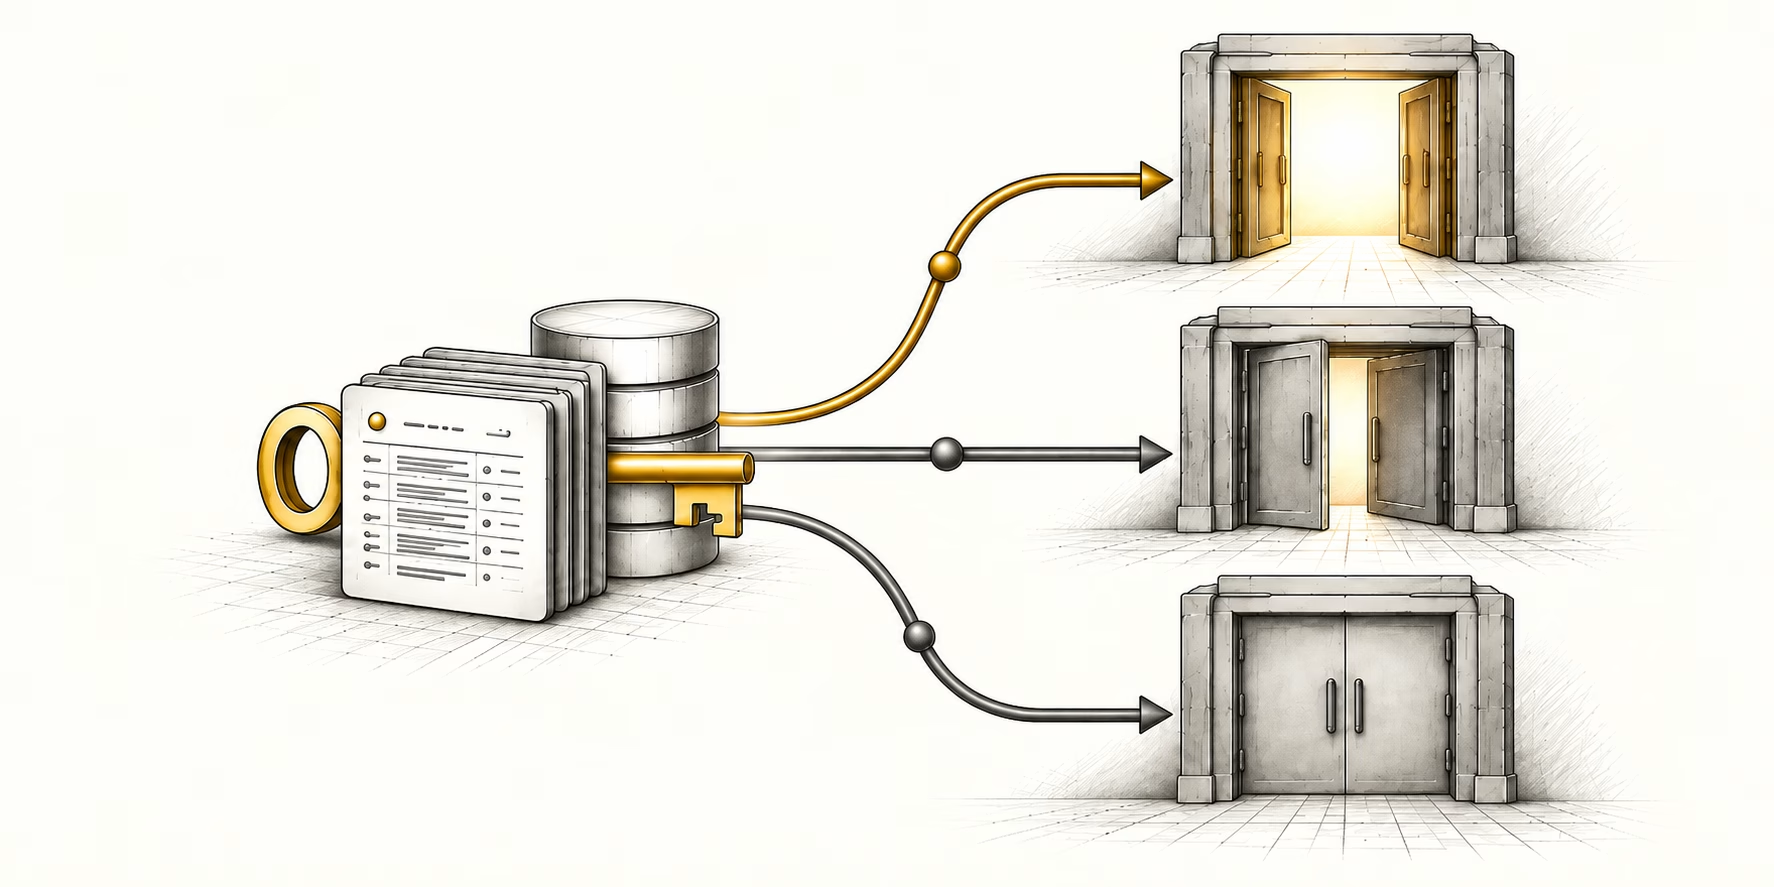
Im vorherigen Beitrag ging es um eine Frage, die bei KI- und Datenvorhaben leicht zu spät geklärt wird: Welche Entscheidung soll durch das Vorhaben eigentlich besser werden?
Für das fiktive Unternehmen Nordwerk war die Antwort am Ende konkreter geworden. Ein Modell soll helfen, drohende Schäden an einer Frässpindel so früh zu erkennen, dass Produktion und Instandhaltung zwischen Weiterbetrieb, zusätzlicher Diagnose und vorgezogener Wartung belastbarer entscheiden können. Damit steht der Verwendungszweck fest, nun muss Nordwerk prüfen, ob die vorhandenen Daten dazu passen.
In den historischen Daten fallen drei Punkte auf:
- Bei rund 8 Prozent der historischen Messpunkte fehlen einzelne Temperaturwerte.
- Die meisten dokumentierten Schadensfälle stammen aus einer älteren Spindelgeneration und teilweise anderen Betriebsbedingungen.
- Eine besonders aussagekräftige Bewertung der Instandhaltung ist in den historischen Daten vollständig vorhanden. Sie wird allerdings erst nach einer zusätzlichen Diagnose erfasst – also zu einem Zeitpunkt, an dem das Modell die Entscheidung über genau diese Diagnose bereits hätte unterstützen sollen.
Welches dieser Probleme würden Sie zuerst angehen?
Kurzfassung für Entscheider öffnen
Kernaussage
Ob Daten für ein Vorhaben brauchbar sind, hängt von der vorgesehenen Nutzung ab. Vollständigkeit, Genauigkeit oder technische Verfügbarkeit allein reichen für diese Beurteilung nicht aus. Relevant ist auch, ob die Daten das richtige Phänomen abbilden, die entscheidenden Fälle enthalten und zum benötigten Zeitpunkt im realen Prozess verfügbar sind. Welche zeitliche Verfügbarkeit dafür tatsächlich erforderlich ist, hängt von der vorgesehenen Reaktion ab, diesen Aspekt vertieft der Beitrag „Brauchen Sie wirklich Echtzeitdaten?“.
Fachliche Begründung
Datenqualität umfasst mehrere messbare Merkmale. Welche Qualität nötig ist, hängt von der konkreten Verwendung und Entscheidung ab.
Größte Unsicherheit
Es gibt keinen universellen Grenzwert, ab dem ein Datensatz für unterschiedliche Entscheidungen gleichermaßen geeignet ist. Die Bedeutung einer Datenlücke verändert sich mit dem Verwendungszweck.
Praktische Konsequenz
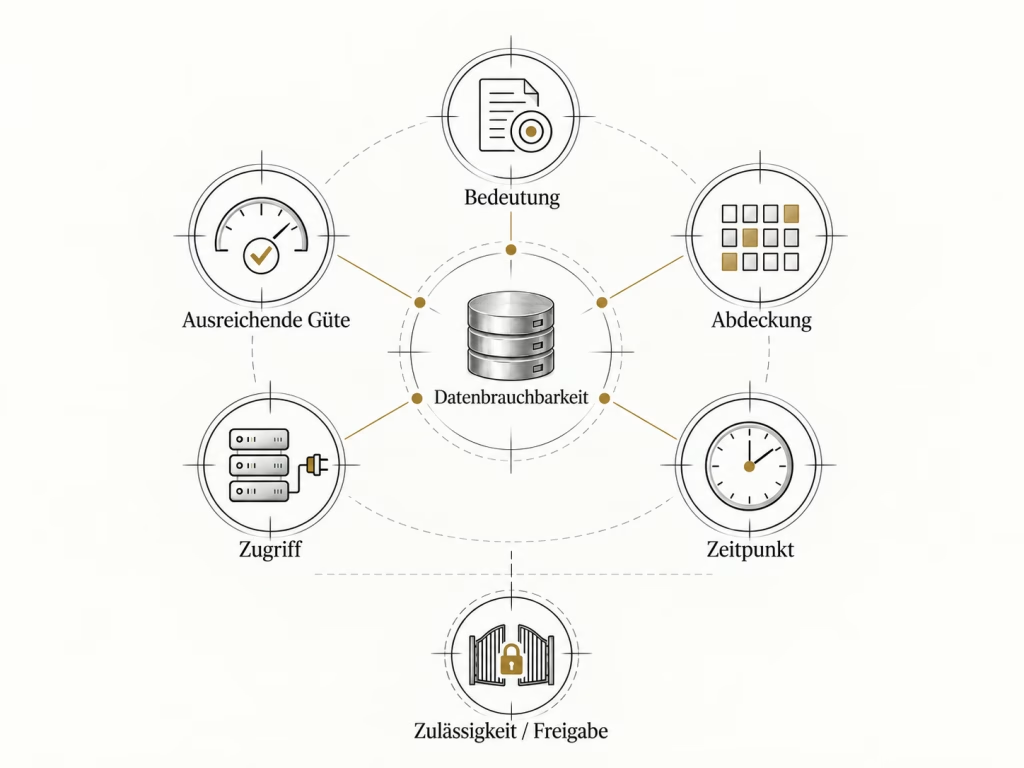
Vor der eigentlichen Eignungsprüfung steht eine grundlegende Frage: Dürfen die Daten für den vorgesehenen Zweck überhaupt verwendet werden und liegen die notwendigen Freigaben vor? Erst wenn dieses Fundament steht, sollten Bedeutung, Abdeckung, Zeitpunkt, Zugriff und ausreichende Güte für die konkrete Entscheidung bewertet werden.
Die 8 Prozent fehlen – aber was bedeutet das?
Bei Nordwerk fehlen bei rund 8 Prozent der historischen Messpunkte einzelne Temperaturwerte. Das ist ein messbarer Qualitätsbefund, aber noch keine Aussage darüber, wie stark die Lücke die spätere Entscheidung beeinträchtigt.
Vielleicht fehlen die Messwerte zufällig über Jahre verteilt und lassen sich für die geplante Analyse gut handhaben. Vielleicht setzt der Temperatursensor aber gerade unter hoher Belastung aus – also genau in Situationen, in denen sich auch der Zustand der Spindel verändert. Derselbe Prozentwert hätte dann eine ganz andere Bedeutung.
Offen ist außerdem, wie wichtig die Temperatur für die Prognose tatsächlich ist: Sie könnte einen wesentlichen Hinweis auf einen bevorstehenden Schaden enthalten, möglicherweise liefern Vibrationsdaten dieselbe Information aber auch zuverlässiger.
Die Messbarkeit eines Problems sagt noch wenig darüber aus, wie stark es die spätere Entscheidung gefährdet.
Vollständigkeit lässt sich bequem quantifizieren und erhält deshalb schnell Aufmerksamkeit. Ein schwieriger zu messendes Problem kann für den vorgesehenen Einsatz trotzdem wesentlich relevanter sein.
Datenqualität umfasst mehrere Merkmale, deren Bedeutung vom Einsatzkontext abhängt. Für Analysen und maschinelles Lernen lassen sich diese Merkmale gezielt prüfen. [1] [3]
Eine Datenlücke lässt sich erst sinnvoll bewerten, wenn klar ist, wofür die betroffenen Daten gebraucht werden.
Saubere Daten können aus einer anderen Realität stammen
Nordwerk besitzt gut dokumentierte historische Schadensfälle mit Sensorwerten und nachvollziehbaren Wartungen. Viele dieser Fälle stammen allerdings aus einer älteren Spindelgeneration und teilweise aus anderen Betriebsbedingungen. Sorgfältig gepflegte Daten können deshalb nur eingeschränkt zu der Umgebung passen, in der das spätere Modell eingesetzt werden soll.
Nehmen wir an, 99 Prozent aller historischen Maschinenstunden wären vollständig erfasst. Das wäre ein hoher Erfassungsgrad, aber noch kein Nachweis, dass die Daten für eine Schadensprognose geeignet sind. Wenn der Bestand fast ausschließlich normalen Betrieb zeigt und seltene hochbelastete Zustände kaum enthält, fehlen möglicherweise gerade die entscheidenden Situationen.
Hier geht es nicht primär um die Qualität einzelner Datensätze, sondern um unterschiedliche Verteilungen historischer Daten und heutiger Einsatzbedingungen. Im Machine Learning wird dafür unter anderem der Begriff Dataset- oder Distribution Shift verwendet. Für die praktische Prüfung zählt die Frage:
Sind die Fälle, Bedingungen und Teilgruppen ausreichend vertreten, auf die das spätere Ergebnis angewendet werden soll?
Ein guter Durchschnitt kann verbergen, dass gerade die entscheidenden Fälle schwach abgedeckt sind.
Eine andere Ursache unzureichender Abdeckung ist Selection Bias: Dabei entsteht eine Verzerrung dadurch, welche Fälle überhaupt in den beobachteten Datensatz gelangen. Das ist nicht dasselbe wie Nordwerks veränderte Spindelgeneration. Diesen Auswahlmechanismus vertiefen wir beim Thema Selection Bias (Artikel ausstehend).
Das scheinbar beste Merkmal kommt zu spät
Das dritte Problem wirkt zunächst wie ein Vorteil: In den historischen Daten findet Nordwerk eine Bewertung der Instandhaltung, die spätere Schäden offenbar außergewöhnlich gut erkennen lässt.
Diese historische Technikerbewertung liegt für die dokumentierten Fälle vollständig vor, erscheint fachlich plausibel und lässt spätere Schäden offenbar gut erkennen. Sie entsteht jedoch erst nach einer zusätzlichen Diagnose, über deren Notwendigkeit das geplante Modell gerade helfen soll zu entscheiden.
Hier liegt ein Fall von zeitlichem Data Leakage vor: Das Modell erhält bei der Entwicklung eine Information, die zum späteren Entscheidungszeitpunkt noch nicht verfügbar wäre. Dadurch kann seine gemessene Vorhersageleistung besser erscheinen, als sie im realen Einsatz tatsächlich wäre. Merkmale aus dem Training müssen deshalb auch zum Zeitpunkt der späteren Vorhersage verfügbar sein. [5]
Für Nordwerk folgt daraus: Dieses Merkmal kann für die vorgesehene Entscheidung nicht in dieser Form verwendet werden. Damit ist aber nicht automatisch das gesamte Vorhaben blockiert.
Vielleicht liefern andere, früher verfügbare Sensordaten ausreichend Information, oder die Technikerbewertung lässt sich durch eine rechtzeitig erfassbare Größe ersetzen. Erst wenn das Merkmal für den gewählten Lösungsansatz wesentlich ist und kein geeigneter Ersatz existiert, wird sein Ausfall zum möglichen Blocker. Deshalb würde ich dieses Problem zuerst klären: Noch steht nicht fest, ob das Vorhaben scheitert; hier lässt sich aber früh prüfen, ob das scheinbar starke Merkmal für die reale Nutzung infrage kommt.
Drei Probleme – und eine andere Priorität
Die drei Auffälligkeiten lassen sich nun unterschiedlich einordnen. Die fehlenden Temperaturwerte sind ein messbarer Qualitätsbefund, dessen Folgen noch untersucht werden müssen. Die älteren Schadensfälle begrenzen möglicherweise die Übertragbarkeit auf aktuelle Betriebsbedingungen. Bei der Technikerbewertung ist dagegen bereits bekannt, dass sie zum benötigten Zeitpunkt fehlt; offen bleibt, ob andere Informationen sie ersetzen können. Der sichtbarste Fehleranteil gibt damit noch keine sinnvolle Prüfpriorität vor. Die erforderliche Datenqualität hängt vom Verwendungszweck ab, sodass derselbe Datensatz für unterschiedliche Entscheidungen unterschiedlich geeignet sein kann. [2]
Gate 0: Dürfen die Daten überhaupt verwendet werden?
Bis hierhin haben wir die drei Auffälligkeiten bewusst fachlich betrachtet. Im realen Prüfprozess gehört davor jedoch ein Fundament: Die vorgesehene Datennutzung muss zulässig und freigegeben sein.
Ist die vorgesehene Nutzung der Daten zulässig und sind die dafür notwendigen Freigaben vorhanden?
Dieses Gate ist kein weiterer Qualitätsaspekt neben Vollständigkeit, Abdeckung oder Aktualität. Es bildet das Fundament, auf dem die weitere Datenprüfung aufsetzt.
- Datenschutz und zulässiger Verarbeitungszweck,
- Nutzungs- und Zugriffsrechte,
- Vertraulichkeits- und Schutzanforderungen,
- interne Freigaben,
- regulatorische Anforderungen.
Der europäische AI Act zeigt für regulierte KI-Anwendungen, wie eng Datenqualität und Data Governance miteinander verbunden sein können. Für Hochrisiko-KI-Systeme, bei denen Modelle mit Daten trainiert werden, verlangt Artikel 10 unter anderem geeignete Governance- und Managementpraktiken für Trainings-, Validierungs- und Testdaten. Dazu gehören beispielsweise die Herkunft der Daten, bei personenbezogenen Daten der ursprüngliche Erhebungszweck, Annahmen darüber, was die Daten messen und repräsentieren sollen, ihre Verfügbarkeit und Eignung sowie die Prüfung möglicher Verzerrungen und relevanter Datenlücken. [7]
Diese konkreten Anforderungen gelten nicht pauschal für jedes KI- oder Datenvorhaben. Ob und welche Vorschriften des AI Acts oder anderer Regelwerke greifen, hängt vom jeweiligen System und Einsatzkontext ab. Der zugrunde liegende Entscheidungsgrundsatz ist jedoch allgemeiner:
Daten sollten erst dann für den vorgesehenen Anwendungsfall weiterverwendet werden, wenn ihre Nutzung dafür zulässig und freigegeben ist.
Für diese Grundlagenprüfung gilt eine strengere Logik als bei den späteren Eignungsdimensionen:
Erfüllt: Die vorgesehene Datennutzung ist für den betrachteten Zweck geklärt und erforderliche Freigaben liegen vor.
Bedingt erfüllt: Es bestehen noch klar benannte Rechts-, Schutz- oder Freigabefragen. Zulässig sind nur die notwendigen Klärungsaktivitäten im dafür vorgesehenen Rahmen; die Daten werden noch nicht für den eigentlichen Anwendungsfall freigegeben.
Nicht erfüllt: Die vorgesehene Nutzung ist nicht zulässig oder eine erforderliche Freigabe fehlt. Die Daten dürfen für diesen Anwendungsfall nicht weiterverwendet werden.
Für den Übergang zur regulären Eignungsprüfung muss Gate 0 erfüllt sein. Vorher kann eine begrenzte, rechtmäßige und datensparsame Sichtung nötig sein, um Herkunft, Schutzbedarf oder Nutzungsrechte zu klären; sie ist jedoch keine Freigabe zur Modellierung oder späteren Nutzung.
Der Umfang solcher Vorprüfungen richtet sich nach dem rechtlich zulässigen Rahmen.
Erst auf diesem Fundament stellt sich die nächste Frage: Sind die zugelassenen Daten für die konkrete Entscheidung auch tatsächlich brauchbar?
Fünf Prüffragen zur Datenbrauchbarkeit
Nach dem bestandenen Gate 0 lässt sich der Nordwerk-Fall zu fünf Eignungsfragen verdichten. Sie sind keine Punkteskala, sondern helfen dabei, unterschiedliche Arten von Datenproblemen auseinanderzuhalten.
1. Bedeutung
Bilden die Daten das Phänomen ab, über das später entschieden werden soll?
Eine sauber dokumentierte Wartung ist beispielsweise nicht dasselbe wie ein tatsächlich bevorstehender Spindelschaden.
Manchmal erfassen wir eine Größe sehr zuverlässig, obwohl sie das eigentlich relevante Ziel nur indirekt beschreibt.
Solche Stellvertretergrößen werden im Machine Learning häufig als Proxy Labels bezeichnet. Ein solcher Stellvertreter kann das gewünschte Ergebnis nur unvollständig abbilden. [4]
Welche Verzerrungen daraus entstehen können, vertiefen wir beim Measurement- und Proxy-Bias (Artikel ausstehend).
2. Abdeckung
Sind die relevanten Fälle, Populationen und Betriebsbedingungen ausreichend vertreten?
Große Datenmengen helfen wenig, wenn gerade die später kritischen Situationen kaum vorkommen. Bei seltenen Spindelstörungen zählt auch, wie viele unabhängige relevante Ereignisse verfügbar sind. Viele Messpunkte rund um wenige Störungen ersetzen keine ausreichende Ereignisbasis. Ein kleines Beispiel kann die Entscheidungslogik erklären, ohne damit eine belastbare Trainings- oder Validierungsbasis zu liefern. Diese Grenze und ihre Bedeutung für den Business Case vertieft der Beitrag „Wenn der Business Case an einer Zahl kippt, die im PoC gar nicht gemessen wird“.
3. Zeitpunkt
Liegt die Information vor, bevor die zu unterstützende Entscheidung getroffen werden muss?
Dass eine Information in historischen Daten vorhanden ist, beantwortet diese Frage noch nicht.
4. Zugriff
Kann die Information im realen Prozess zuverlässig und mit vertretbarem Aufwand bereitgestellt werden?
Ein manueller Export kann für eine einmalige Analyse genügen. Für eine regelmäßig benötigte Produktionsentscheidung gelten andere Voraussetzungen.
5. Ausreichende Güte
Sind Genauigkeit, Vollständigkeit, Konsistenz, Aktualität und Granularität für den konkreten Zweck ausreichend?
Der relevante Maßstab ist hier nicht Perfektion. Entscheidend ist, ob die verbleibenden Einschränkungen für den vorgesehenen nächsten Schritt vertretbar sind.
Warum fünf Einzelbewertungen keine Gesamtnote brauchen
Nach einem erfüllten Gate 0 lässt sich die eigentliche Eignungsprüfung leicht in einer Tabelle dokumentieren.
Für die folgende Einordnung nehmen wir an, dass der aktuell betrachtete Lösungsansatz die Technikerbewertung tatsächlich benötigt.
| Dimension | Einordnung | Kurzbegründung |
|---|---|---|
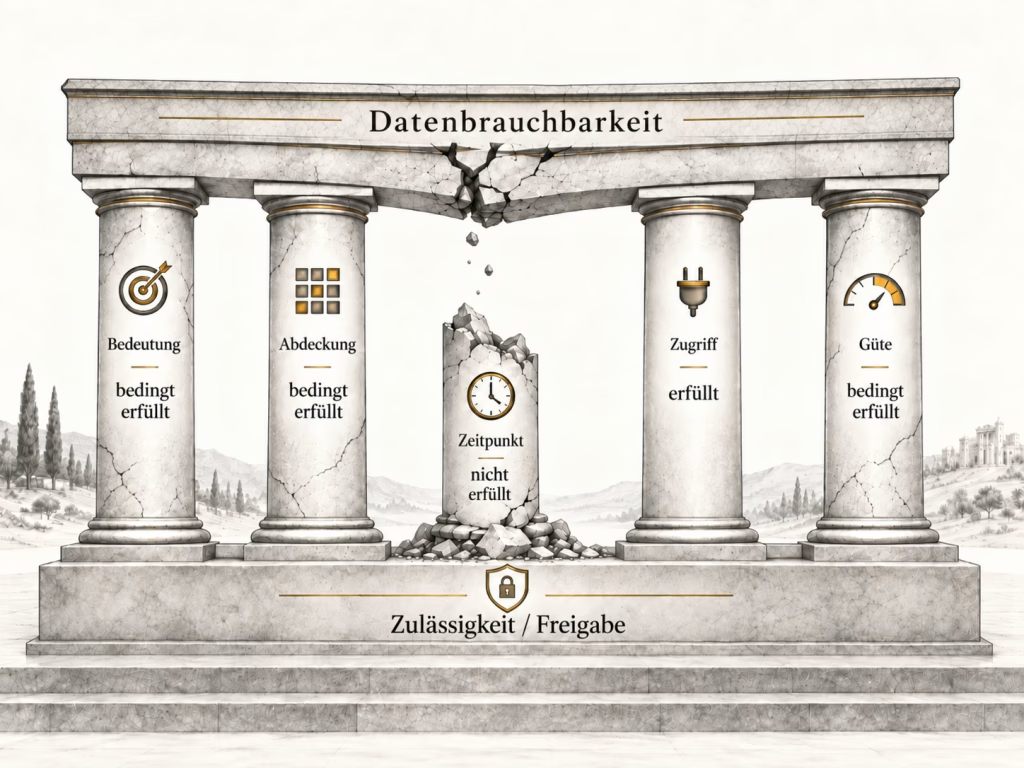
| Bedeutung | bedingt erfüllt | Relevante Sensordaten sind vorhanden, aber der tatsächliche Beitrag einzelner Merkmale zur Entscheidungsfrage ist noch zu prüfen. |
| Abdeckung | bedingt erfüllt | Viele historische Fälle liegen vor, aber ältere Spindelgenerationen und andere Betriebsbedingungen begrenzen die Übertragbarkeit. |
| Zeitpunkt | nicht erfüllt | Die Technikerbewertung entsteht erst nach der Entscheidung, die unterstützt werden soll. |
| Zugriff | erfüllt | Die benötigten Daten sind im beschriebenen Szenario grundsätzlich verfügbar und technisch nutzbar. |
| Ausreichende Güte | bedingt erfüllt | Unter anderem fehlen Temperaturwerte; ihre tatsächliche Relevanz für die Entscheidung muss noch bewertet werden. |
Die erste Einordnung beschreibt den Zustand einer Prüfdimension. Blocker, materielles Risiko oder tolerierbare Unvollkommenheit beschreiben anschließend die Konsequenz dieses Befunds für den nächsten Schritt.
Ein Gesamtscore könnte diese Unterscheidung verwischen.
Vier Dimensionen können erfüllt oder bedingt erfüllt sein. Wenn bei einer für den gewählten Lösungsansatz zwingenden Voraussetzung jedoch „nicht erfüllt“ steht, darf dieser Befund nicht durch andere gute Bewertungen rechnerisch kompensiert werden.
Das bedeutet nicht, dass Kennzahlen oder Messungen nutzlos wären. Vollständigkeit, Aktualität, Fehlerquoten und andere Merkmale lassen sich sinnvoll beobachten und verbessern.
Die Grenze liegt bei der Entscheidungslogik:
Kennzahlen helfen bei der Bewertung; sie dürfen kritische Voraussetzungen jedoch nicht rechnerisch kompensieren.
Für die Projektentscheidung ist deshalb oft aussagekräftiger, wesentliche Lücken einzeln einzuordnen:
Blocker: Eine notwendige Voraussetzung ist nicht ausreichend erfüllt und verhindert den ausdrücklich benannten nächsten Schritt oder würde dessen Ergebnis unvertretbar verzerren.
Materielles Risiko: Der nächste Schritt ist möglich, eine bekannte Unsicherheit kann das Ergebnis jedoch wesentlich beeinflussen.
Tolerierbare Unvollkommenheit: Die Einschränkung ist bekannt und für den aktuellen Zweck begrenzt akzeptabel.
Die Tabelle ersetzt keine detaillierte Datenanalyse. Sie macht aber sichtbar, welche Art von Problem vorliegt – und verhindert, dass eine einzelne kritische Voraussetzung in einer scheinbar guten Gesamtnote verschwindet.
Eigene Erfahrung: Datenreife bedeutet auch, weglassen zu können
Einen weiteren Aspekt habe ich in Machine-Learning-Projekten mit großen Datenmengen erlebt:
Bei einem großen Bestand potenzieller Inputmerkmale lautete die entscheidende Frage nicht, was sich grundsätzlich in ein Modell einspeisen lässt. Wir mussten gezielt auswählen, welche Informationen für die Modellaufgabe tatsächlich hilfreich waren und welchen Aufwand ihre Nutzung später im Produktivbetrieb erzeugen würde.
Jedes zusätzliche Merkmal kann weitere Datenbeschaffung, Verarbeitung und technische Abhängigkeiten bedeuten. Deshalb gehörten neben dem Beitrag zur Modellierung auch Kosten und Latenz zur Auswahlentscheidung.
Für den späteren Betrieb stellt sich dieselbe Frage: Rechtfertigt der Nutzen eines zusätzlichen Features die Kosten und die weitere Abhängigkeit, die dauerhaft gepflegt werden muss? [6]
Datenreife bedeutet deshalb auch, begründet weglassen zu können.
Datenbrauchbarkeit auf einen Blick
Die Prüfung beginnt mit dem Fundament:
Gate 0 – Zulässigkeit und Freigabe: Dürfen die Daten für diesen Zweck verwendet werden und liegen die notwendigen Freigaben vor?
Für die weitere Verwendung muss dieses Gate erfüllt sein.
Danach folgen fünf Eignungsfragen:
- Bedeutung: Messen wir das Richtige?
- Abdeckung: Sind die relevanten Fälle vertreten?
- Zeitpunkt: Liegt die Information rechtzeitig vor?
- Zugriff: Kann sie im realen Prozess zuverlässig genutzt werden?
- Ausreichende Güte: Ist ihre Qualität für diesen Zweck gut genug?
Die fünf Dimensionen werden einzeln als erfüllt → bedingt erfüllt → nicht erfüllt eingeordnet.
Anschließend wird die Konsequenz wesentlicher Lücken bewertet: Blocker → materielles Risiko → tolerierbare Unvollkommenheit.
Ein kompensierender Gesamtscore ist dafür nicht erforderlich.
Gute Daten werden im Kontext einer Entscheidung brauchbar
Damit lässt sich die Ausgangsfrage beantworten.
Noch bevor Datenqualität und konkrete Eignung gegeneinander abgewogen werden, muss feststehen, dass die Daten für den vorgesehenen Zweck überhaupt genutzt werden dürfen.
Ist dieses Fundament vorhanden, beginnt die eigentliche Brauchbarkeitsprüfung: Passen die Daten tatsächlich zu der Entscheidung, die verbessert werden soll?
Bei Nordwerk führt diese Perspektive zu einer anderen Reihenfolge als der erste Blick auf die Fehlerquoten. Die fehlenden Temperaturwerte müssen geprüft werden. Die historische Datenbasis muss auf ihre Übertragbarkeit untersucht werden. Und die nachträgliche Technikerbewertung fällt als Merkmal zunächst aus, solange keine gleichwertige Information bereits vor der Entscheidung verfügbar ist.
Die zentrale Prüffrage lautet damit:
Welche Datenlücke verändert oder gefährdet die vorgesehene Entscheidung tatsächlich?
Sind die Daten auf dieser Grundlage ausreichend eingeordnet, folgt die nächste Voraussetzung für ein umsetzbares Vorhaben:
Wer entscheidet fachlich über die Auswahl der verwendeten Daten, wer legt Anforderungen fest, wer akzeptiert Ergebnisse – und wer erteilt formale Freigaben oder entscheidet bei Zielkonflikten?
Wer darf eigentlich Ja sagen? Wenn Verantwortlichkeiten ein KI-/Datenvorhaben blockieren führt diese Frage weiter.
Zusammenfassung
Kernaussage: Daten werden erst im Kontext einer konkreten Entscheidung sinnvoll als brauchbar oder unbrauchbar bewertbar.
Fundament: Zulässigkeit und notwendige Freigaben müssen für die vorgesehene Nutzung geklärt sein, bevor die Daten regulär weiterverwendet werden.
Prüflogik: Bedeutung, Abdeckung, Zeitpunkt, Zugriff und ausreichende Güte werden einzeln beurteilt – nicht zu einem kompensierenden Gesamtscore verrechnet.
Praktische Konsequenz: Ein einzelnes „nicht erfüllt“ kann bei einer zwingenden Voraussetzung den nächsten Schritt blockieren, selbst wenn andere Dimensionen gut aussehen.
Einseitige Zusammenfassung herunterladen (PDF · 1 Seite)
Quellen
[1] ISO/IEC 5259-2:2024. Artificial intelligence — Data quality for analytics and machine learning (ML) — Part 2: Data quality measures. Zur Quelle
[2] UK Government Data Quality Hub. The Government Data Quality Framework sowie zugehörige Guidance, 2020. Zur Quelle
[3] ISO/IEC 25012:2008. Software engineering — Software product Quality Requirements and Evaluation (SQuaRE) — Data quality model. Zur Quelle
[4] Google for Developers. Framing an ML problem. Zur Quelle
[5] Google for Developers. Production ML systems: Monitoring pipelines. Zur Quelle
[6] Google for Developers. Production ML systems: Questions to ask. Zur Quelle
[7] Verordnung (EU) 2024/1689 – Artificial Intelligence Act, insbesondere Artikel 10. Daten und Daten-Governance. Zur Quelle
Fachlich passende Artikel
Fachlich ergänzt am 4. Oktober 2026: Abgrenzung zwischen Messpunktmenge und unabhängigen Störungsereignissen präzisiert. Redaktionell überarbeitet am 31. Oktober 2026.
Weiter im Facharchiv
Zur Kategorie „Daten & Anforderungen“ · Alle Fachbeiträge · Fachlicher Lernpfad: Von der KI-Idee zur Projektentscheidung · Alle Themenbereiche