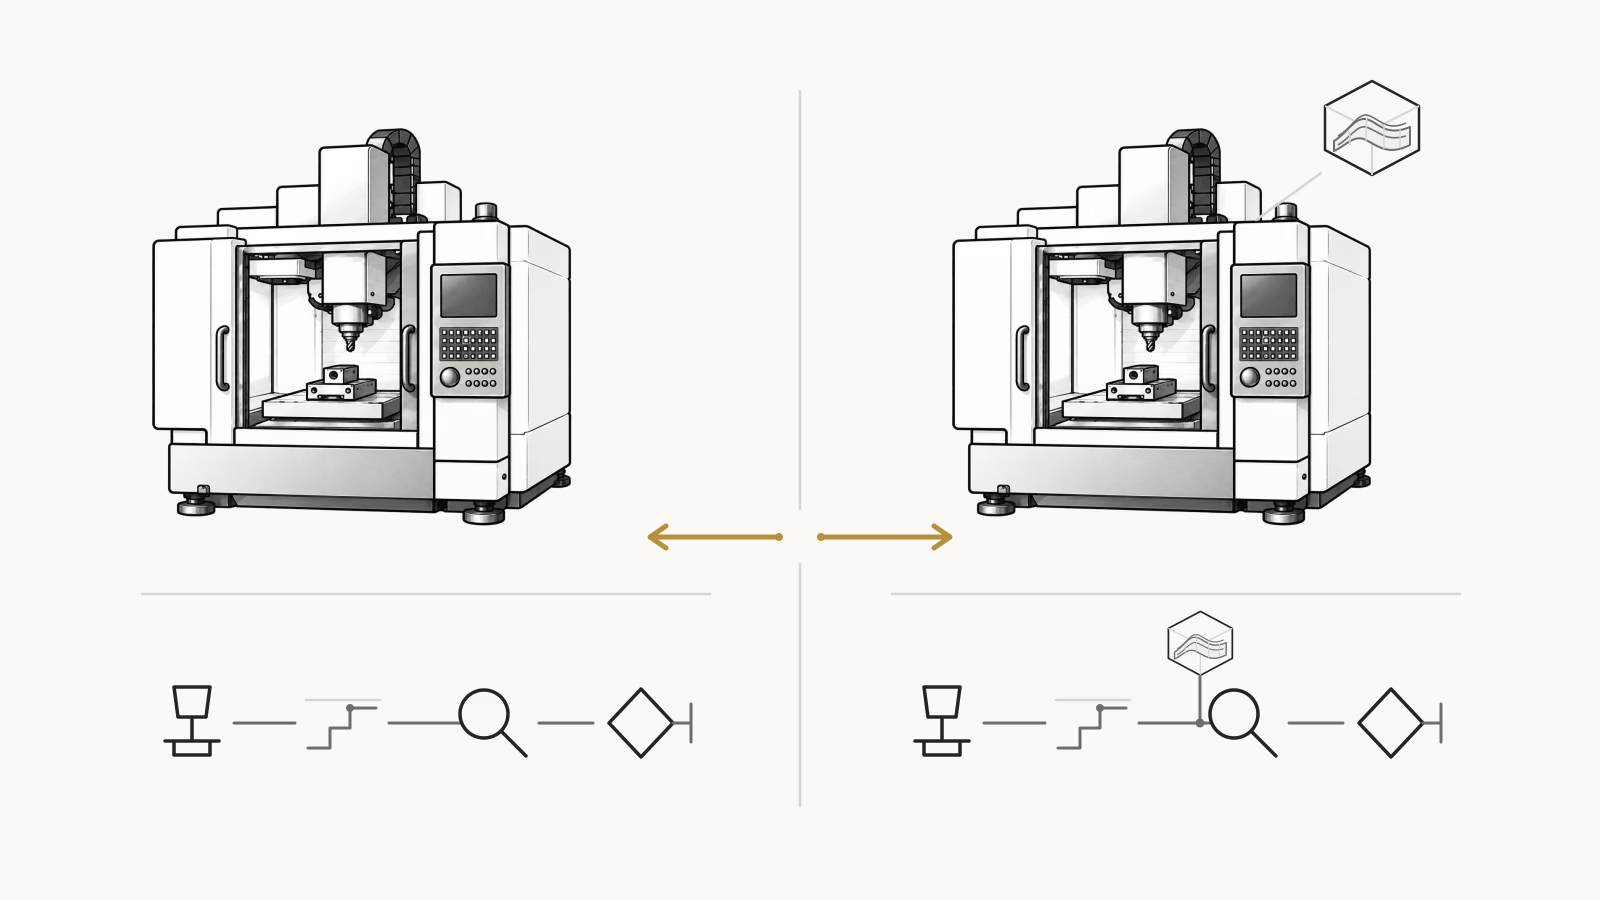
Im Beitrag über offene PoC-Fragen haben wir Nordwerk, einen fiktiven Hersteller mit CNC-Bearbeitungszentren, bis an den Start seines PoC begleitet: An Sensordaten der Spindeln soll er prüfen, ob sich ein kritischer Zustand früh genug erkennen lässt, um eine zusätzliche Diagnose, vorgezogene Wartung oder das Weiterproduzieren besser zu entscheiden. Dafür mussten die Frage, die verfügbaren Daten und die Grenzen des Versuchs klar sein. Wie das Signal technisch am besten gewonnen wird, durfte offenbleiben.
Nun zeigt der Prototyp auf historischen Maschinendaten auffällige Muster und nachvollziehbare Treffer. Für den nächsten Schritt scheint damit vieles zu sprechen. In der Ergebnispräsentation fehlt jedoch eine einfache Frage: Was hätte der bisherige Ablauf in denselben Fällen erkannt?
Ein Proof of Concept (PoC) kann belegen, dass ein technischer Ansatz unter festgelegten Bedingungen funktioniert. Ob dieser Ansatz eine bestehende Entscheidung verbessert, lässt sich aus seiner Leistung allein kaum ableiten. Dafür braucht es einen Vergleich mit dem, was heute tatsächlich geschieht oder als einfachere Alternative möglich wäre.
Nordwerk muss jetzt entscheiden, ob es ein System für frühere Störungshinweise im Betrieb erprobt. Für den weiteren Fall nehmen wir an, dass Nordwerk bei auffälligen Maschinenzuständen bereits eine Grenzwertregel nutzt. Ihre Warnungen fließen in die Prüfung durch die Instandhaltung ein. Welche Baseline sollte das Unternehmen für die Entscheidung über einen Pilot zuerst heranziehen?
- Ein einfaches Modell mit wenigen verfügbaren Sensormesswerten als technische Referenz für den aufwendigeren Prototyp.
- Die vorhandene Grenzwertregel für auffällige Maschinenzustände.
- Den heutigen Instandhaltungsprozess einschließlich Warnungen, Prüfung und Eingriffen.
Alle drei Vergleiche können etwas beitragen. Welcher beantwortet aber die Frage, für die Nordwerk jetzt Geld und Zeit investieren müsste? Darauf kommen wir zurück.
Kurzfassung für Entscheider öffnen
Für Leser mit wenig Zeit: die Kernaussagen dieses Beitrags in kompakter Form.
Kernaussage: Eine Baseline ist der nachvollziehbare Vergleichsmaßstab für ein PoC-Ergebnis. Welche Baseline zählt, hängt von der anstehenden Entscheidung ab.
Stärkste fachliche Grundlage: Ein KI-Modell kann in Tests besser abschneiden als eine einfache Alternative, ohne dadurch den tatsächlichen Arbeitsablauf zu verbessern. Deshalb muss geprüft werden, ob die höhere Modellleistung auch zu besseren Entscheidungen, weniger Aufwand oder geringeren Fehlerkosten im Betrieb führt.
Größte Unsicherheit: Ein nachgewiesener technischer Vorteil bedeutet noch keinen betrieblichen Mehrwert. Offen bleibt häufig, ob die Testergebnisse auf reale Bedingungen übertragbar sind, welche Handlungen das neue Verfahren tatsächlich verändert und ob dadurch messbare Verbesserungen entstehen.
Praktische Konsequenz: Vergleichsmaßstäbe aus der Entscheidungsfrage ableiten: Einfache technische Alternativen prüfen die zusätzliche Leistungsfähigkeit, der heutige Arbeitsablauf den möglichen betrieblichen Nutzen. Für nicht belegte Wirkungen gezielte Praxistests mit klaren Erfolgskriterien vorsehen.
Eine Baseline ist eine Antwort auf „im Vergleich wozu?“
Der Begriff wird in Projekten für verschiedene Dinge verwendet. Ein einfaches Modell kann als technische Ausgangsbasis dienen: Lernt das komplexere Modell überhaupt etwas, das über eine triviale Vorhersage hinausgeht? Eine bestehende Regel beantwortet eine andere Frage: Liefert der neue Ansatz Hinweise, die mit geringerer Komplexität nicht schon verfügbar wären? Der heutige Prozess erweitert den Blick auf die Entscheidung: Was sehen und tun Menschen bisher, und was würde sich durch den neuen Hinweis tatsächlich ändern?
Diese Ebenen sollten nicht ineinander verschwimmen. Ein Modell kann eine einfache Vorhersage deutlich übertreffen und trotzdem kaum zusätzliche Information gegenüber einer gut eingestellten Grenzwertregel liefern. Es kann wiederum die Regel übertreffen, ohne dass daraus im konkreten Ablauf ein sinnvoller neuer Eingriff entsteht. Auch eine Lösung ohne maschinelles Lernen oder eine Heuristik sollte als Maßstab für möglichen Zusatznutzen und Aufwand betrachtet werden.[1] Für technische Experimente kann ein einfaches Modell die erste Baseline sein.[2]
Ob der Vergleich beim einfachen Modell beginnt und danach die vorhandene Regel und den gesamten Instandhaltungsprozess einbezieht, ergibt sich aus der Projektfrage. Wer eine Modellidee erforscht, beginnt möglicherweise mit einer einfachen technischen Referenz. Wer über einen betrieblichen Pilot entscheidet, muss zusätzlich wissen, welche bestehende Handlung der neue Ansatz verbessern könnte. Der Vergleichsmaßstab sollte vor der Auswertung feststehen, damit nicht erst nach Sichtung der Ergebnisse die leichteste Hürde ausgewählt wird. Wie Teams positive Befunde und Einwände mit unterschiedlichen Maßstäben bewerten können, vertieft „Warum intelligente Teams bei KI-Projekten systematisch falsch entscheiden können“.
Nordwerk: Die Antwort auf die Mitdenkfrage
Nordwerk prüft, ob zusätzliche Warnhinweise die bisherige Instandhaltung verbessern könnten. Für die Entscheidung über den Pilot ist deshalb Antwort 3 – der heutige Instandhaltungsprozess – die vorrangige Baseline. Die vorhandene Grenzwertregel aus Antwort 2 gehört dazu und verdient einen gesonderten technischen Vergleich. Antwort 1 zeigt lediglich, ob das Modell über eine sehr einfache Vorhersage hinauskommt. Sie allein würde das Budget für einen betrieblichen Pilot nicht begründen.
Nordwerk müsste zunächst festhalten, was heute bei einer auffälligen Spindel passiert: Welche Signale erhält die Instandhaltung? Wann erfolgt eine zusätzliche Diagnose? Unter welchen Umständen wird Wartung vorgezogen oder weiterproduziert? Erst daran lässt sich die neue Modellmeldung spiegeln. Bei jedem ausgewerteten historischen Fall interessiert dann beispielsweise, ob sie rechtzeitig vor einer möglichen Handlung verfügbar gewesen wäre, ob die vorhandene Regel ebenfalls gewarnt hätte und welche zusätzlichen Prüfungen ein weiterer Alarm ausgelöst hätte.
Eine solche Gegenüberstellung verlangt Zurückhaltung. Frühere Entscheidungen lassen sich nur rekonstruieren, soweit Signale, Zeitpunkte und Handlungen dokumentiert wurden. Aus einer rückblickend richtigen Warnung folgt auch noch nicht, dass ein Instandhalter damals anders gehandelt oder einen Stillstand verhindert hätte. Nordwerks PoC kann den möglichen Informationsgewinn eingrenzen; die Wirkung im Ablauf bleibt eine Aufgabe für den Pilot.
Falls die heutigen Warnungen und Eingriffe nicht ausreichend dokumentiert sind, riskiert Nordwerk mit einer präzisen Verbesserungsbehauptung gegenüber dem Standardprozess eine falsche Einschätzung des Nutzens. Das Unternehmen kann die Grenzwertregel auf geeigneten historischen Fällen prüfen und zugleich im begrenzten Pilot den aktuellen Ablauf und neue Hinweise parallel protokollieren. Die fehlende Baseline wird damit zur ausdrücklich benannten Lernaufgabe, statt stillschweigend durch eine günstige Modellkennzahl ersetzt zu werden.
Der Vergleich muss zum Entscheidungszeitpunkt passen
Ein fairer Vergleich verwendet dieselben geeigneten Fälle und fragt bei beiden Ansätzen, welche Information damals verfügbar gewesen wäre. Werden bei der Modellentwicklung spätere Reparaturbefunde oder Daten aus der Zukunft verwendet, kann das Ergebnis rückblickend überzeugend und für eine echte Vorwarnung wertlos sein. Bei zeitabhängigen Daten sind geeignete Trennungen von Entwicklungs- und Testzeiträumen daher besonders wichtig; eine beliebige zufällige Aufteilung kann die Aussage über künftige Fälle verzerren.[3]
Auch die Testumgebung verdient eine eigene Zeile in der Ergebnisdarstellung. Wurden nur gut dokumentierte Störungen ausgewählt? Fehlen lange störungsfreie Phasen, in denen unnötige Warnungen Aufwand erzeugen würden? Gelten die beobachteten Maschinenzustände, Datenwege und Reaktionszeiten auch im geplanten Einsatz? Für die Aussagekraft des Tests sollten Testdaten, Messgrößen und Unterschiede zwischen Test- und Einsatzumgebung dokumentiert und die Leistung im Anwendungskontext beurteilt werden.[4] Das ist keine vorgeschriebene PoC-Schablone, aber eine nützliche Gegenprobe für die Aussagekraft des Ergebnisses.
Für Nordwerk wäre ein Vergleich ausschließlich auf ausgewählten Störungsfällen zu eng. Die Instandhaltung muss ebenso mit unauffälligen Betriebsphasen leben, in denen jeder zusätzliche Hinweis eine Prüfung auslösen kann. Wie häufig solche Hinweise auftreten dürfen und welche Fehler schwerer wiegen, ist eine eigene fachliche Entscheidung. Wie Modellmetriken im Zusammenhang mit einer vorgesehenen Handlung zu bewerten sind, vertiefe ich im Beitrag 92 % Genauigkeit: Würden Sie damit einen Prozess automatisieren? Die wirtschaftliche Bewertung konkreter Fehlerfolgen bleibt eine eigene Frage. Hier geht es darum, beide Vorgehensweisen auf einer passenden gemeinsamen Grundlage zu beurteilen.
Was mir ein Fehlerklassifikationsprojekt gezeigt hat
Nordwerks PoC darf seine Treffer nicht isoliert vom bisherigen Ablauf bewerten. Wie leicht man sonst den falschen Vergleich zieht, habe ich in einem eigenen Projekt zur Fehlerklassifikation mit maschinellem Lernen erlebt. In einzelnen Fehlerklassen erzielte das Modell eine hohe Genauigkeit. In anderen Klassen waren seine Aussagen deutlich weniger verlässlich. Nach meiner Beobachtung litt darunter die Glaubwürdigkeit des Systems insgesamt: Die Anwender hatten schließlich ein grundsätzliches Problem damit, den Modellaussagen zu vertrauen.
Die fachliche Baseline war der bisherige Standardprozess. Für eine Verbesserung gegenüber diesem Prozess reichten die guten Ergebnisse einzelner Klassen nicht aus: Entscheidend war, ob das Modell über die benötigten Fehlerklassen hinweg zu insgesamt verlässlicheren und nutzbaren Ergebnissen führte. Hinzu kam ein Aufwand, den die Modellkennzahlen nicht zeigten. Die Klassifikationsergebnisse mussten in der Entwicklung aufwendig überprüft werden. Der zusätzliche Aufwand entstand dort und nicht bei den späteren Anwendern.
Aus den guten Einzelwerten ließ sich also kein besseres Gesamtergebnis gegenüber dem Standardprozess ableiten. Für diesen Vergleich zählen auch die Schwächen in den anderen Klassen, das Vertrauen der Anwender und die zusätzliche Überprüfungsarbeit im Zielprozess. Ein Vergleich mit der Baseline muss Ergebnis und Aufwand des gesamten Ablaufs erfassen, auch wenn dieser Aufwand an einer anderen Stelle entsteht als der spätere Nutzen. Für Nordwerk heißt das: Ein früherer Spindelhinweis zählt erst im Zusammenhang mit den bisherigen Warnungen, möglichen Handlungen und zusätzlichen Prüfungen. Wie sich aus zusätzlicher Information ein wirtschaftlicher Nutzen ergeben kann und welche ungeprüften Annahmen die Rechnung verändern, behandelt die Vertiefung zum Business Case nach dem PoC.
Ein Vergleich kann mehrere Ergebnisse liefern
Die Baseline sollte nicht zu einer einzigen Zahl verkürzt werden, wenn das Vorhaben mehrere Folgen hat. Für eine begrenzte nächste Projektentscheidung reichen oft wenige, sauber getrennte Fragen:
- Technischer Zugewinn: Welche relevanten Fälle erkennt der neue Ansatz zusätzlich gegenüber einer einfachen Regel oder einem einfachen Modell?
- Handlungsbezug: Kommt der Hinweis früh und verständlich genug, um eine andere Prüfung oder Entscheidung zu ermöglichen?
- Gesamtaufwand: Welche Prüfungen, Korrekturen und laufenden Arbeiten entstehen im Vergleich zum bisherigen Ablauf, und bei wem fallen sie an?
- Grenzen: Für welche Maschinen, Fehlerarten, Situationen oder Datenbedingungen lässt sich aus dem Test noch nichts Belastbares sagen?
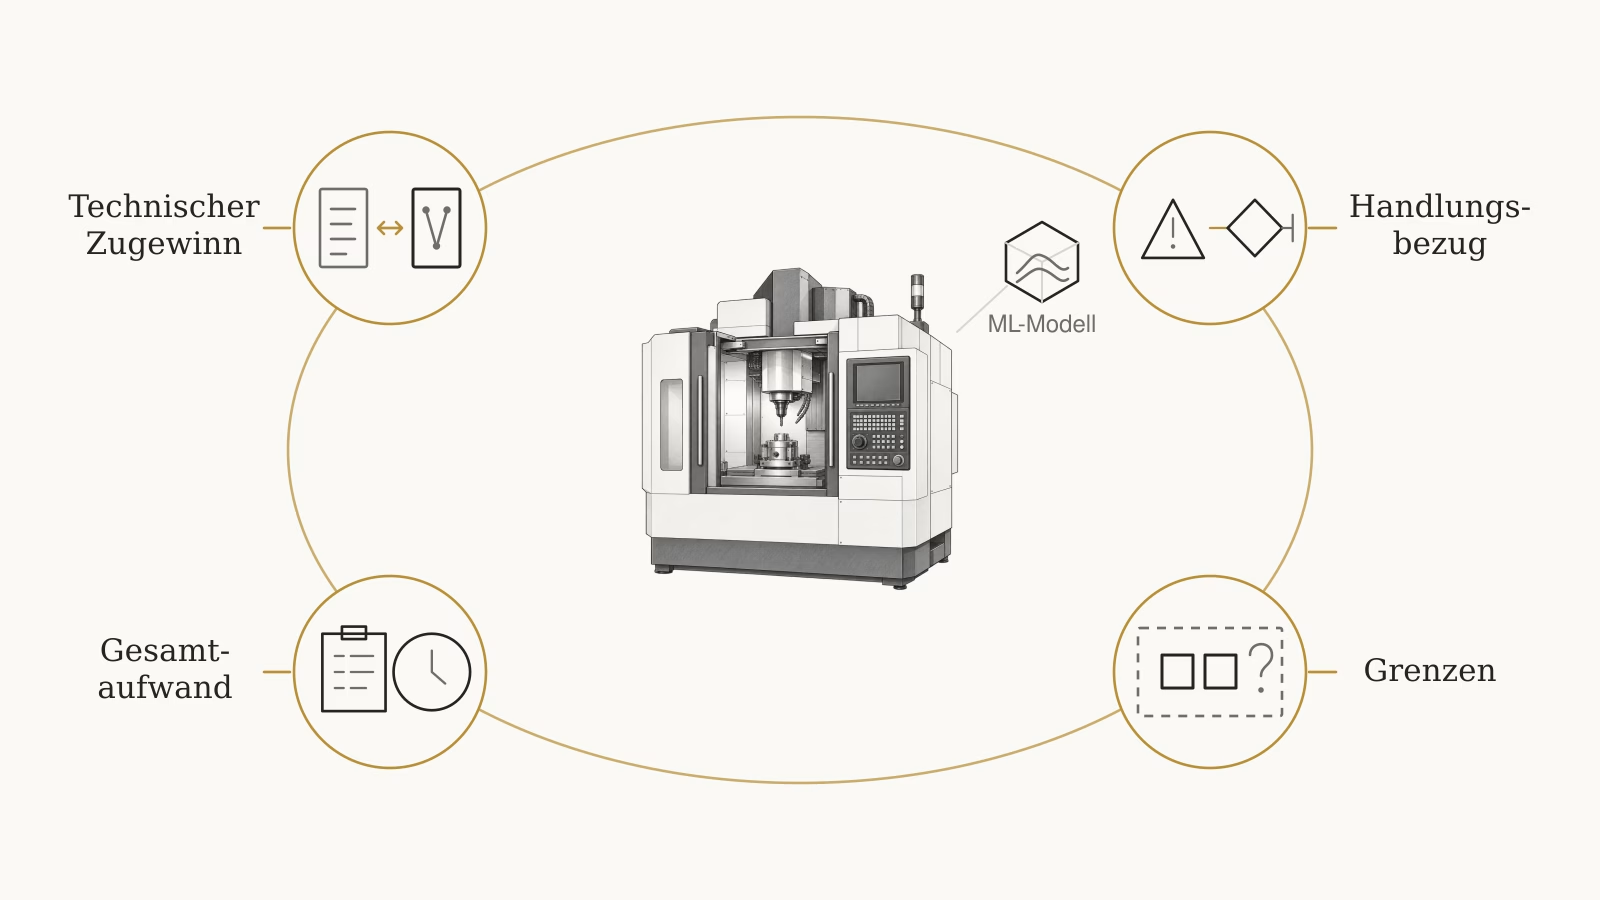
Diese vier Fragen sind eine Ordnung für die Entscheidung, keine universelle Bewertungsmethode. Im einen Projekt zählt ein kleiner Zugewinn bei einer schwerwiegenden Fehlerart stark. In einem anderen kann derselbe Zugewinn durch viele zusätzliche Prüfungen aufgezehrt werden. Ohne Angaben zu Häufigkeiten, Handlungen und Folgen wäre eine allgemeine Gewichtung erfunden.
Ein PoC muss dabei nicht bereits den wirtschaftlichen Gesamtnutzen nachweisen. Gerade frühe Versuche sollen Unsicherheit gezielt verringern. Er darf mit dem Ergebnis enden, dass eine technische Idee funktioniert, der Zusatznutzen gegenüber dem Bestehenden aber noch offen ist. Dann ist die nächste Frage konkret: Lässt sich die fehlende Evidenz mit einer besseren historischen Gegenprobe gewinnen, braucht es einen begrenzten Pilot, oder spricht die einfache Alternative bereits gegen weitere Komplexität? Wie sich daraus ein begründeter nächster Beschluss ableiten lässt, vertiefe ich im Beitrag Wann ist Nicht-Weiterführen das beste Ergebnis eines KI-Projekts?
Welche Antwort trägt den nächsten Schritt?
Nordwerk sollte für den Pilotentscheid den heutigen Instandhaltungsprozess als maßgebliche Baseline beschreiben und die vorhandene Grenzwertregel zusätzlich auf denselben geeigneten Fällen prüfen. Der PoC kann dann zeigen, wo das Modell möglicherweise früher oder anders informiert. Er kann auch ergeben, dass die bestehende Regel bereits einen großen Teil dieses Nutzens liefert. Fehlen Aufzeichnungen über bisherige Warnungen und Handlungen, bleibt dieser Teil der Bewertung offen und muss im Pilot gezielt erhoben werden.
Die Antwort auf die Ausgangsfrage lautet daher: Ein PoC wird entscheidbar, wenn sein Ergebnis gegen die ernsthafte Alternative für die anstehende Entscheidung geprüft wird – mit vergleichbaren Fällen, dem damaligen Informationsstand und sichtbaren Grenzen der Aussage. Eine technische Baseline prüft das Modell; der Vergleich mit dem bisherigen Ablauf zeigt, ob daraus ein zusätzlicher Nutzen entstehen könnte. Ob dieser Nutzen im Betrieb tatsächlich eintritt, verlangt weitere Evidenz.
Zusammenfassung
- Die geeignete Baseline hängt von der Entscheidung ab: Ein einfaches Modell, eine bestehende Regel und der heutige Arbeitsablauf beantworten verschiedene Fragen.
- Für Nordwerks Pilotentscheidung hat der bisherige Instandhaltungsprozess Vorrang. Die Grenzwertregel wird zusätzlich auf denselben Fällen geprüft.
- Historische Vergleiche müssen berücksichtigen, welche Daten und Handlungen zum damaligen Zeitpunkt verfügbar waren. Sie belegen vermiedene Ausfälle nicht allein.
- Auch Prüfaufwand und Vertrauen in die Aussagen gehören zum Vergleich mit dem Standardprozess; sie können außerhalb der späteren Nutzung entstehen.
- Fehlende Informationen über den Ist-Prozess sind ein offenes Ergebnis des PoC und eine konkrete Aufgabe für den nächsten, begrenzten Test.
Einseitige Zusammenfassung herunterladen (PDF · 1 Seite)
Quellen
- Google for Developers: Understand the problem, Abschnitt „Clear use case for ML“ und „State the goal“, Stand 25. August 2025, geprüft am 26. September 2026. https://developers.google.com/machine-learning/problem-framing/problem
- Google for Developers: Experiments, Abschnitt „Determine baseline performance“, Stand 25. August 2025, geprüft am 26. September 2026. https://developers.google.com/machine-learning/managing-ml-projects/experiments
- scikit-learn: Cross-validation: evaluating estimator performance, Abschnitte zu Testdaten und „Cross validation of time series data“, geprüft am 26. September 2026. https://scikit-learn.org/stable/modules/cross_validation.html
- National Institute of Standards and Technology (NIST): AI Risk Management Framework Playbook – Measure, Measure 2.1 zu Testdaten und Messgrößen sowie Measure 2.3 zu Einsatzbedingungen und Unterschieden zur Testumgebung, geprüft am 26. September 2026. https://airc.nist.gov/airmf-resources/playbook/measure/