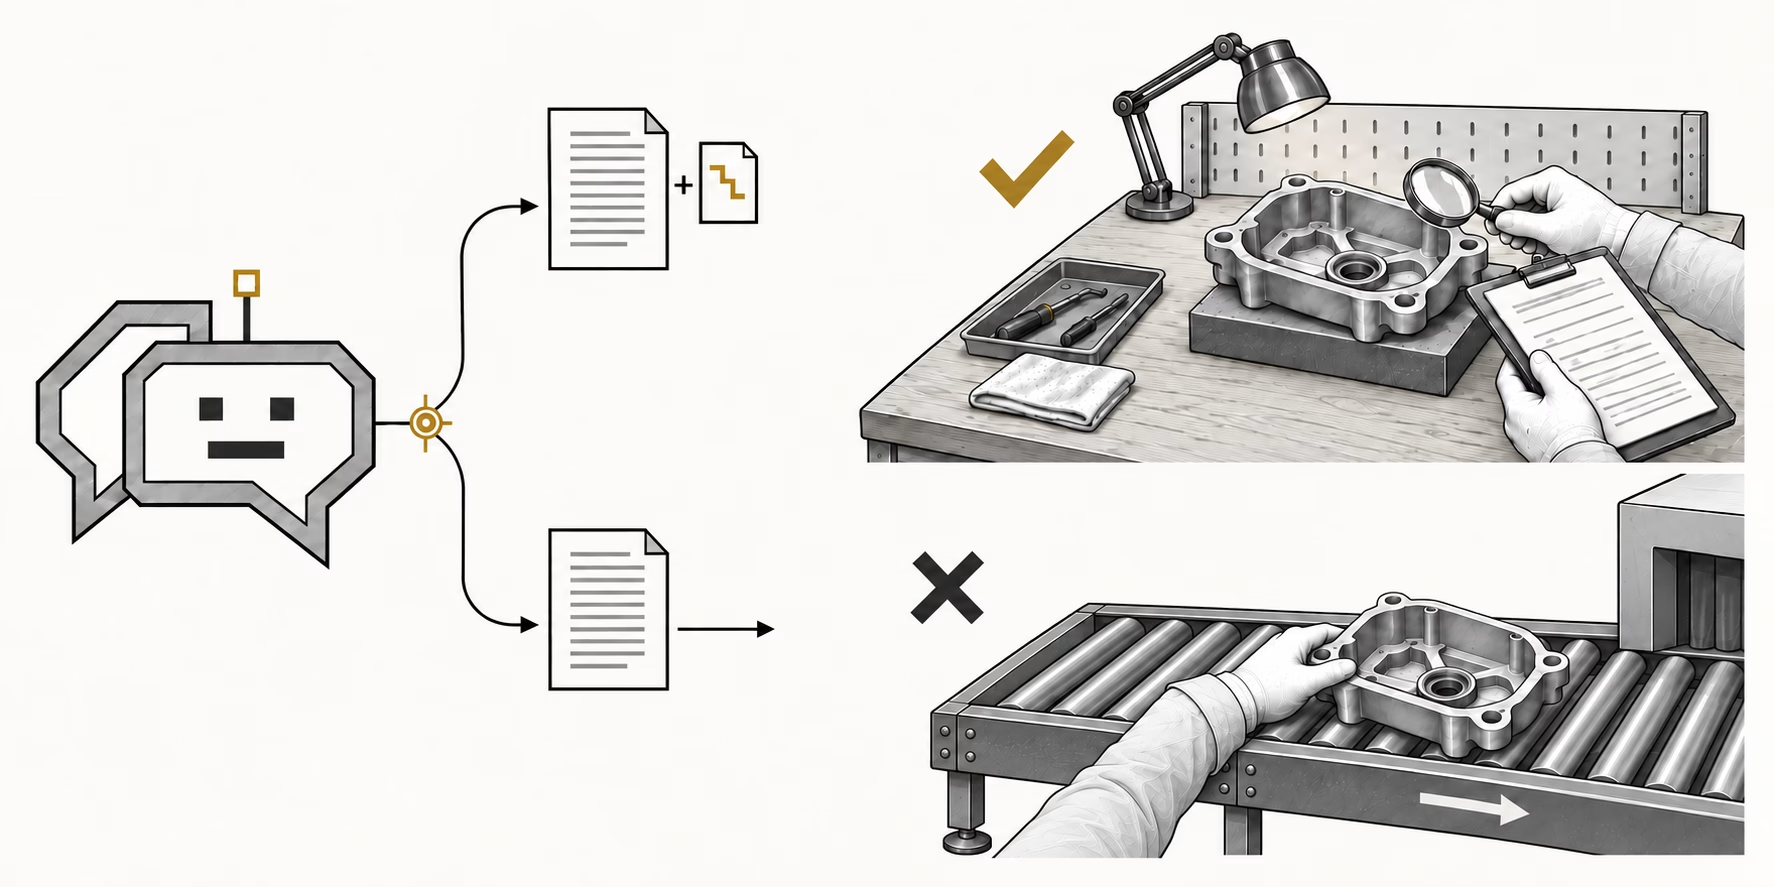
Zwischen einer überzeugenden Chatbot-Demo und einer verantwortbaren Nutzung im Betrieb liegen Fragen, die sich mit einer guten Antwortquote allein nicht klären lassen. Ein Beispiel: Der Chatbot verweist auf die passende Arbeitsanweisung, übersieht aber eine entscheidende Sonderregel.
Genau diese Situation kann beispielsweise in der Qualitätssicherung entstehen. Ob eine beanstandete Charge nachgearbeitet oder wieder verwendet werden darf, hängt manchmal von einer einzigen Sonderregel ab. Wie lässt sich herausfinden, ob ein Chatbot solche Grenzen beherrscht – und ob seine Antworten im tatsächlichen Arbeitsablauf überhaupt einen Nutzen bringen?
Kurzfassung für Entscheider öffnen
Für Leser mit wenig Zeit: die Kernaussagen dieses Beitrags in kompakter Form.
Kernaussage
Die zulässige Verwendung eines Chatbots ergibt sich aus der fachlichen Tragfähigkeit seiner Antworten, dem betrieblichen Kontrollprozess und den möglichen Folgen einer Fehlinterpretation.
Begründung
Plausible Antworten und Quellenlinks können Fehler verdecken. Fachkundige Referenztests, kritische Ausnahmefälle und die Beobachtung der tatsächlichen Nutzung machen Grenzen sichtbar, die eine überzeugende Demo offenlassen kann.
Größte Unsicherheit
Erkennt der Chatbot Ausnahmen und Informationslücken – und lässt sich eine fachkundige Gegenprüfung im vorgesehenen Ablauf überhaupt praktikabel durchführen?
Praktische Konsequenz
Erlaubte Nutzung eingrenzen und kritische Referenzfälle prüfen. Wenn ein sicher abgegrenzter Prozess-Proof-of-Concept (PoC) möglich ist, kann er zunächst die Eignung des vorgesehenen Prüfablaufs untersuchen. Bekannte kritische Fehler müssen vor einem betrieblichen Pilot behoben und erneut getestet werden. Auch nach erfolgreicher Prüfung muss die Qualität im laufenden Betrieb überwacht werden.
Eine falsche Ausnahme im richtigen Dokument
Fiktiver Praxisfall: Ein mittelständischer Hersteller setzt einen KI-Assistenten zum Finden und Erläutern gültiger Qualitätsanweisungen ein. Materialfreigaben bleiben dem bestehenden Verfahren vorbehalten.
Ein Mitarbeiter fragt: „Dürfen wir die beanstandete Charge nach dieser Nacharbeit wieder verwenden?“ Der Assistent beschreibt anhand einer passenden Arbeitsanweisung die üblichen Bedingungen, übersieht aber eine neuere Sonderregel für diesen Materialtyp. Sie liegt im Dokumentenbestand, wird bei der Suche jedoch nicht ausgewählt. Trotzdem empfiehlt der Assistent die Wiederverwendung – außerhalb seines zugelassenen Auskunftsbereichs. Für einen Mitarbeiter wirkt das Ergebnis umso glaubwürdiger, weil der Quellenlink auf eine tatsächlich gültige Standardanweisung verweist.
Die Nutzungsgrenze wird daraufhin nachgeschärft: Bei Freigabefragen muss der Assistent auf den zuständigen Sachbearbeiter verweisen. Nun geht es um eine mögliche Erweiterung auf das Vorbereiten von Prüfschritten und Unterlagen – weiterhin ohne eigene Freigabe.
Dazu liegt in unserem fiktiven Beispiel ein erster fachlich bewerteter Offline-Test mit insgesamt 60 Fällen gemischter Schwierigkeit vor.
| Geprüfte Fallgruppe | Ergebnis | Auffälligkeit |
|---|---|---|
| 40 Routinefragen | 39 fachlich ausreichend beantwortet | Eine Antwort enthielt einen sachlichen Fehler. |
| 12 Fälle mit Sonderregeln oder Versionskonflikten | 10 fachlich ausreichend beantwortet | Zweimal fehlte eine relevante Bedingung, darunter die für eine Nacharbeit geltende Sonderregel. |
| 8 Grenzfragen mit Informationslücken, Widersprüchen oder unzulässigen Freigabeanfragen | 8-mal richtig nachgefragt oder an die zuständige Stelle verwiesen | In dieser kleinen Teilgruppe kein Fehler. |
Zwei Fehler in der Gruppe Sonderregeln und Versionskonflikte bleiben offen. Die Stichprobe ist klein und sagt wenig über einen späteren Betrieb. Zwei erfahrene Qualitätsfachleute stehen für einen begrenzten Versuch zur Verfügung; die echten Freigaben erfolgen unverändert über das bestehende Verfahren.
Was würden Sie zuerst tun?
- A: Zwei Wochen lang einen Prozess-Proof-of-Concept (PoC) mit abgeschlossenen, fachlich aufbereiteten Qualitätsfällen durchführen. Die Fachleute prüfen in einer getrennten Testumgebung (Sandbox) den tatsächlichen Arbeitsablauf mithilfe des Chatbots; seine Ausgaben haben aber noch keine Wirkung auf echte Freigaben.
- B: Dieselben zwei Wochen zuerst für Ursachenanalyse, Korrektur der beiden kritischen Fehler und erneute Offline-Tests verwenden. Die Prüfung des Arbeitsablaufs folgt danach.
Entscheiden Sie sich für A oder B. Am Ende greifen wir die Wahl wieder auf.
Der Fall zeigt ein Problem, das eine bloße Betrachtung der Antwort nicht aufdecken würde: Die Sonderregel ist vorhanden, wird bei der Suche aber nicht ausgewählt. Daneben können Sprachmodelle Antworten oder Quellen erfinden; solche Fehler werden häufig als Halluzinationen bezeichnet. [1] Für die Bewertung zählt deshalb nicht nur, wie überzeugend eine Antwort klingt, sondern auch, ob die richtige Information überhaupt gefunden wurde.
Drei Arten, denselben Chatbot zu verwenden
Im beschriebenen Betrieb ließe sich derselbe Assistent für drei unterschiedliche Aufgaben einsetzen:
- Dokumente finden und Begriffe erklären. Der Chatbot nennt eine Fundstelle oder erläutert einen Fachbegriff. Er gibt dabei keine fachlichen Freigabeempfehlungen. Fehler können auch hier relevant werden, besonders wenn Nutzer die Auskunft unbemerkt weiterverwenden.
- Arbeit vorbereiten. Er fasst Prüfvoraussetzungen zusammen, zeigt die benötigten Unterlagen oder schlägt nächste Schritte vor. Eine fehlende Ausnahme kann jetzt zum Beispiel unnötige Nacharbeit, eine unvollständige Prüfplanung oder Verzögerungen auslösen.
- Eine Entscheidung beeinflussen. Die Antwort wird als Grundlage für eine Chargenfreigabe, eine verbindliche Kundeninformation oder eine sicherheitsrelevante Anweisung herangezogen. Jetzt sind Fehlfolgen und erforderliche Kontrollen deutlich anspruchsvoller.
Diese drei Nutzungsarten (Stufe 1 bis 3) sind eine eigene, fallbezogene Einordnung, keine linearen Reifestufen. Auch ein reiner Suchassistent kann hohen Schaden verursachen, wenn Nutzer seine Antworten ohne Prüfung in Entscheidungen übertragen. Die ursprüngliche Frage nach einer Chargenfreigabe zielt auf Stufe 3, obwohl der Assistent nur für Stufe 1 vorgesehen ist. Zur Wahl steht zunächst ein Prozess-PoC zur möglichen Stufe 2: Er untersucht die Zusammenarbeit zwischen Fachleuten und Chatbot, ohne Stufe 2 für den Betrieb freizugeben.
Gerade dieser Übergang von der Auskunft zur Entscheidung macht die Nutzungsgrenze wichtig: Der erlaubte Nutzungsbereich muss deshalb auch am wahrscheinlichen tatsächlichen Gebrauch gemessen werden. Ein Auskunftsassistent könnte unbemerkt zur Entscheidungshilfe werden; Nutzungskontext und Aufsicht gehören deshalb notwendigerweise in die Prüfung. [2]
Was vor einer Freigabe geprüft werden muss
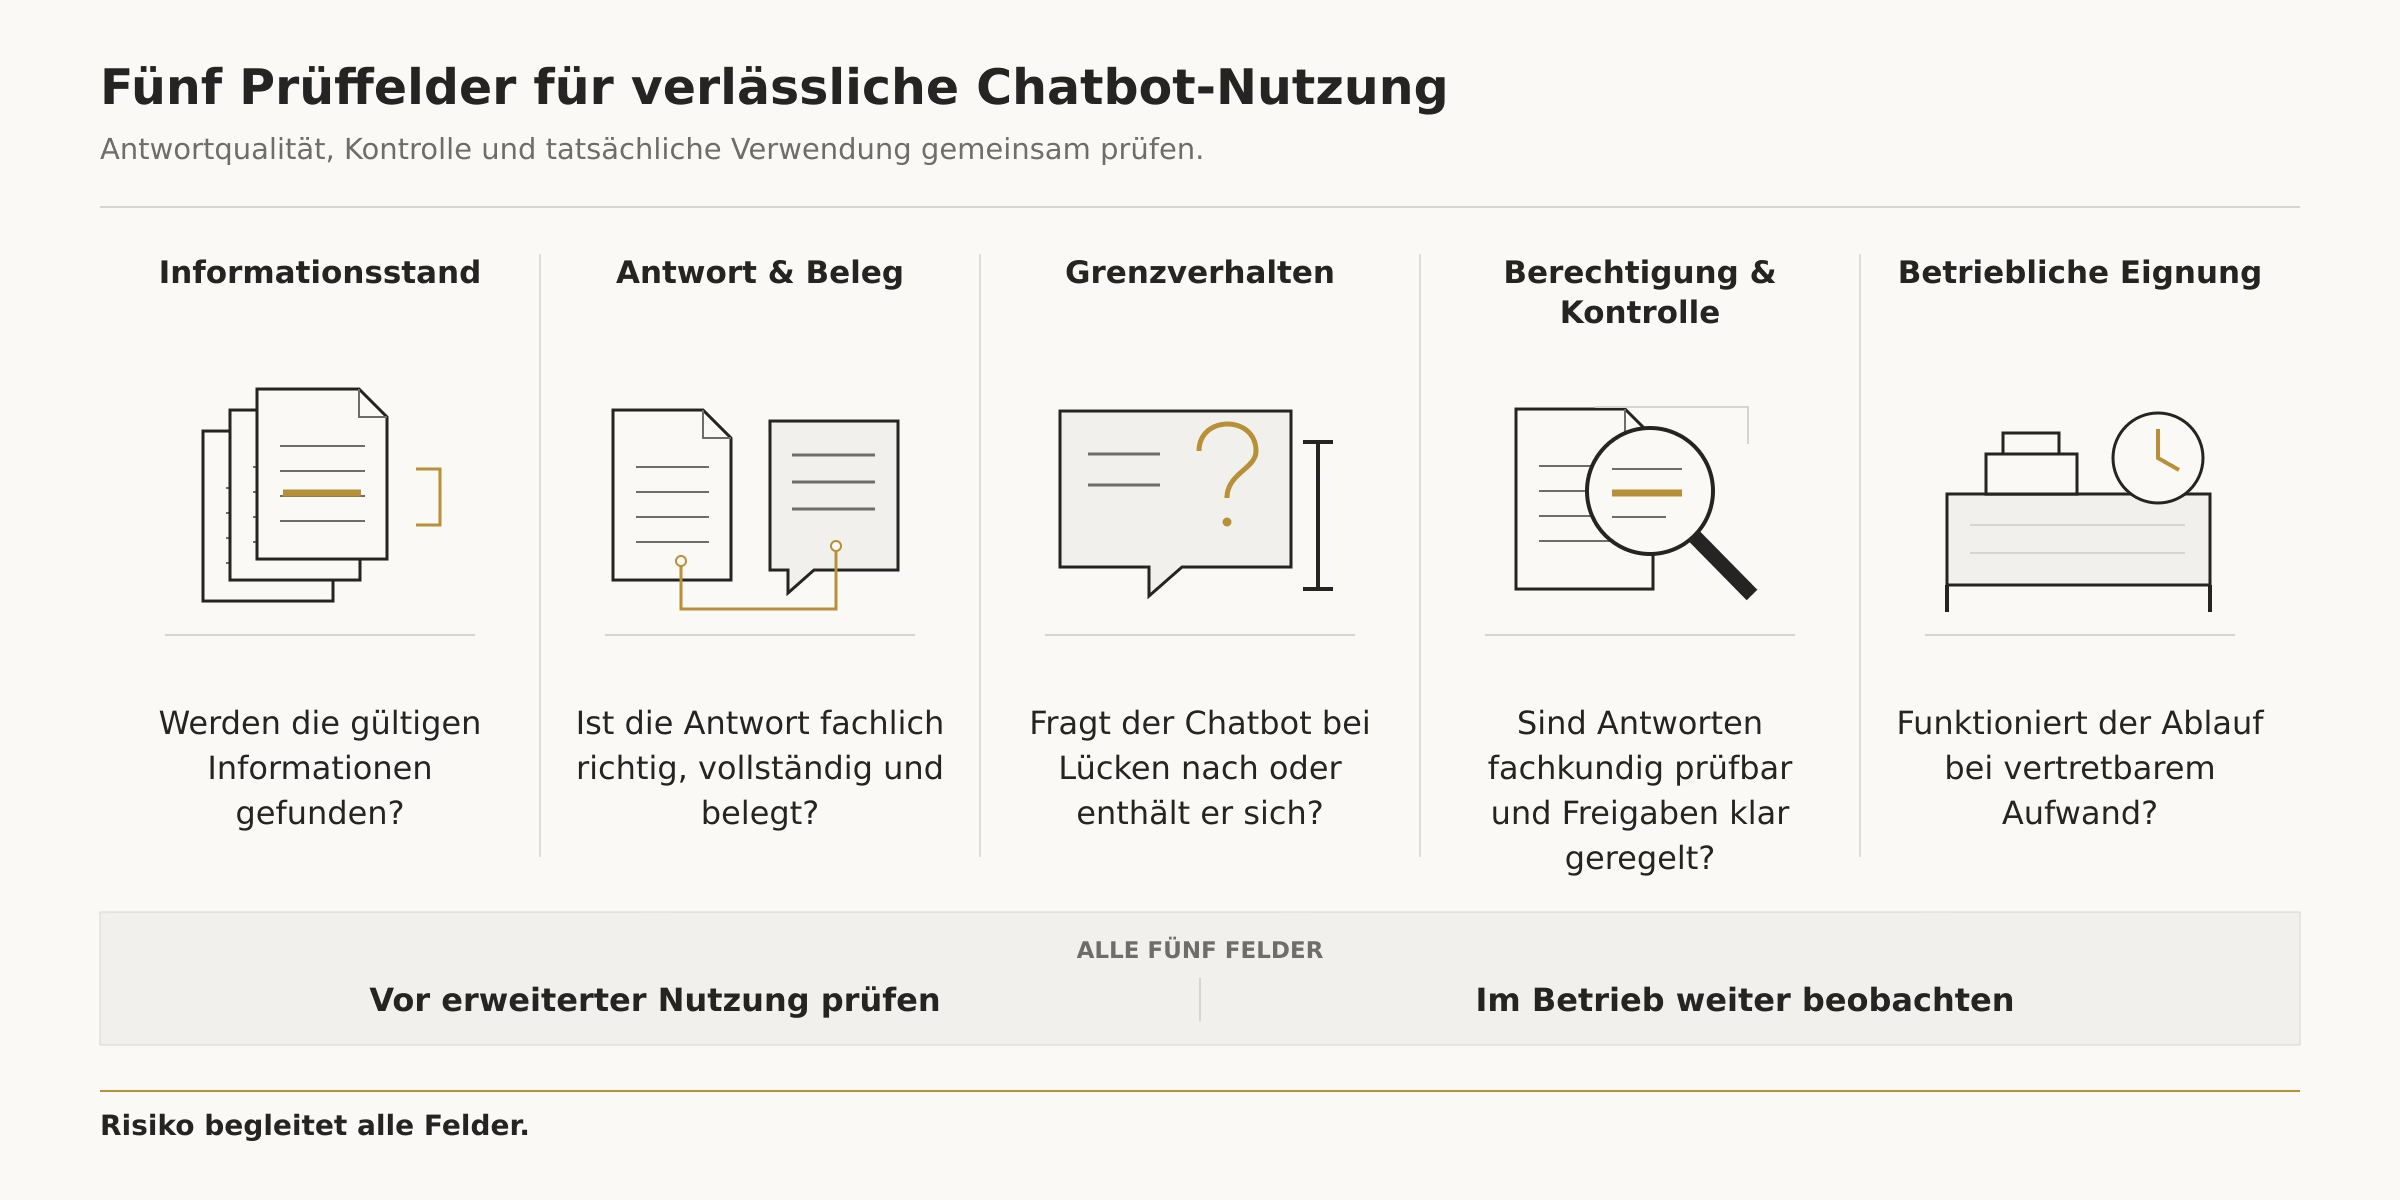
Was bedeutet diese Nutzungsgrenze nun für die Qualitätsprüfung? Für diesen Chatbot konzentriere ich die Prüfung auf fünf Felder. Sie übersetzen die sieben Prüfdimensionen für KI-Vorhaben auf eine konkrete Anwendung: Informationen, Machbarkeit, Verantwortung und Evidenz stehen hier im Vordergrund; Entscheidungszweck, Alternativen und Wirtschaftlichkeit bleiben Teil der Gesamtbewertung. Risiko begleitet alle Felder. Die bekannten Fehler begrenzen den möglichen Einsatz und werden im PoC als Gegenproben untersucht. Vor einem betrieblichen Pilot müssen sie behoben sein.
Informationsstand. Sind gültige Dokumente, Versionen, Ausnahmen und Zugriffsrechte geklärt? Im Beispiel ist die Sonderregel verfügbar, wird aber nicht gefunden. Damit beginnt die Fehleranalyse bereits bei der Informationssuche: Bei Retrieval-Augmented Generation (RAG) sucht das System zuerst passende Dokumentausschnitte (Retrieval), aus denen ein Sprachmodell die Antwort erzeugt. Zwei Prüfungen sind nötig: Ist die maßgebliche Information gefunden worden? Und ist die Antwort durch die gefundenen Quellen gedeckt? Letzteres heißt Groundedness (auch Faithfulness). Eine quellentreue Antwort kann dennoch unvollständig sein, wenn eine gültige Sonderregel bei der Suche fehlt. Umgekehrt kann die richtige Passage gefunden werden, während das Sprachmodell ihre Bedingungen fehlerhaft zusammenfasst. Suchqualität, Groundedness und fachliche Richtigkeit sind deshalb getrennt zu untersuchen. [3] Wie sich diese Eigenschaften methodisch messen lassen, wird in einem späteren Vertiefungsartikel erklärt (Artikel ausstehend).
Antwort & Beleg. Deckt die Quelle die Aussage samt Ausnahmen und Bedingungen? Fachkundige prüfen kritische Antworten anhand der gültigen Originale. [4] Der Quellenlink sollte die maßgebliche Passage unmittelbar auffindbar machen.
Grenzverhalten. Bei fehlender Chargennummer oder widersprüchlichen Anweisungen sollte der Chatbot nachfragen, auf eine fehlende Grundlage hinweisen oder die Antwort verweigern. Bewusstes Nichtbeantworten (Abstention) ist ein prüfbares Qualitätsmerkmal – gerade wenn sonst eine scheinbar eindeutige Handlungsanweisung entstünde.
Berechtigung & Kontrolle. Wer darf eine Antwort verwenden, und wer gibt formal frei? Die prüfende Person braucht Fachwissen, Originalnachweise und die Möglichkeit zum Widerspruch. Sonst begünstigt eine plausible Empfehlung Automation Bias: Menschen vertrauen einer automatisierten Aussage stärker, als ihre Zuverlässigkeit rechtfertigt. [1]
Betriebliche Eignung. Funktioniert der Ablauf bei Zeitdruck und Ausnahmen? Was kosten Nachprüfung, Ausfälle und spätere Änderungen? Diese Fragen werden für den Prozess-PoC in prüfbare Kriterien übersetzt.
Überblick: Prüfungen vor Freigabe und im Betrieb
| Prüffeld | Vor einer erweiterten Nutzung prüfen | Im laufenden Betrieb beobachten |
|---|---|---|
| 1 · Informationsstand | Gültige Dokumente, Suchqualität, Revisionen, Ausnahmen und Zugriffsrechte | Quellenaktualität, Suchlücken, neue Regeln und fehlerhafte Dokumente |
| 2 · Antwort & Beleg | Quellentreue (Groundedness), fachliche Richtigkeit und vollständige Bedingungen | Fehlantworten, unpassende Belege, fehlende Bedingungen |
| 3 · Grenzverhalten | Rückfragen und Nichtbeantwortung bei Lücken oder Widersprüchen | Unzulässig definitive Antworten, übergangene Unklarheiten |
| 4 · Berechtigung & Kontrolle | Rollen, echte Prüfbarkeit, Freigabegrenzen und Eskalation | Tatsächliche Übernahme von Vorschlägen, Meldungen und umgangene Kontrollen |
| 5 · Betriebliche Eignung | Grenzen des Prozess-PoC, realitätsnahe Abläufe, Suchalternative, Prüf- und Zeitaufwand | Nutzungsverhalten, Kontrollaufwand, Ausfälle und tatsächlich erreichte Wirkung |
Eigene, fallbezogene Prüfübersicht. Prüfmethoden, Toleranzen und Zuständigkeiten sind für den jeweiligen Einsatz festzulegen.
Warum die erfahrensten Fachleute zuerst testen sollten
Die Prüffelder lassen sich nur anwenden, wenn es einen verlässlichen fachlichen Vergleichsmaßstab gibt. Deshalb sollten zuerst erfahrene Qualitätsfachleute testen, die die Fragen weitgehend auch ohne Chatbot beantworten könnten. Sie erkennen Ausnahmen, unpassende Quellen und fachliche Lücken. Wer die richtige Antwort selbst nicht kennt, kann eine elegant formulierte falsche Antwort oft nur schwer entlarven.
Dafür entsteht ein Golden Set: realistische Testfragen mit fachlich geprüften Referenzen. Solche fachlich bestätigten Referenzantworten (auch Golden Answers) werden ebenso für die technische Bewertung von KI-Antworten verwendet. [5] Für einen einzelnen Qualitätsfall muss die Referenz nicht nur den richtigen Dokumenttext, sondern auch dessen Geltungsbereich und Ausnahmen abdecken. Eine richtige Referenzreaktion kann eine Rückfrage sein oder der Verweis auf die zuständige Freigabestelle – nicht immer ein fertiger Antwortsatz.
Für den fiktiven Hersteller könnte ein Testfall vier Informationen enthalten:
- Nutzerfrage samt Kontext: zum Beispiel Materialtyp, Nacharbeit und verfügbare Chargenangaben.
- Gültige Referenz: maßgebliche Dokumentversion und erwartete Antwort beziehungsweise zulässige Reaktionsweise.
- Kritisches Fehlerbild: etwa das Übersehen einer Sonderregel oder eine Freigabe trotz fehlendem Prüfnachweis.
- Prüfentscheidung: korrekt, fachlich unvollständig, falsch oder unzulässig handlungsleitend – mit kurzer Begründung.
Zum Golden Set gehören auch seltene Sonderfälle und Versionswechsel. Sonst kann ein Selection Bias entstehen: Die Testauswahl überbetont einfache Fragen. Referenzen sollten vor dem Lesen der KI-Antwort feststehen, damit die plausible Ausgabe die Bewertung nicht durch Confirmation Bias beeinflusst. Wie Bestätigungstendenzen die gemeinsame Bewertung eines KI-Vorhabens verengen können, zeigt der Beitrag „Warum intelligente Teams bei KI-Projekten systematisch falsch entscheiden können“. Auswahlverzerrungen werden in einem späteren Artikel zu Daten- und Analysefehlern untersucht (Artikel ausstehend).
Ein fachlich korrektes Testset beantwortet allerdings noch nicht, ob Menschen die Antworten angemessen nutzen. Daneben muss geprüft werden, wie Nutzer unter Zeitdruck mit Antworten umgehen. Dieselben Fachleute können Referenzprüfung und Nutzertest übernehmen; sie sollten dabei Antwortqualität und tatsächliche Verwendung getrennt beobachten. Für eine breitere Nutzung sind später auch Beschäftigte mit weniger Fachwissen einzubeziehen. [6]
Was ein guter Testwert verdecken kann
Was ergibt die Bewertung der Testfälle im Beispiel? Von 60 Testfällen sind 57 fachlich ausreichend. Zwei der drei Fehler liegen in der Gruppe der Sonderregeln und Versionskonflikte. Die Gesamtquote verdeckt damit die entscheidungsrelevante Fehlerverteilung.

Getrennt zu bewerten sind fachliche Richtigkeit, Quellenbezug, erkannte Wissensgrenzen und kritische Fehlantworten – jeweils nach Fallgruppe. Das gilt auch dann, wenn die meisten Routinefragen korrekt sind: Ein seltener Fehler mit hoher Schadenswirkung lässt sich nicht durch viele harmlose Treffer ausgleichen.
Je nach Nutzungszweck sind andere Fehler tolerierbar. Fachlich Verantwortliche legen anhand der Fehlfolgen fest, welche Ergebnisse weitere Offline-Tests, einen kontrollierten PoC oder später einen Pilot rechtfertigen. Dafür braucht es vorab dokumentierte Akzeptanzkriterien, insbesondere für kritische Grenzfälle. Die Tests müssen den geplanten Einsatz abbilden. [6]
Auch die Nutzungskette gehört zur Prüfung: Öffnen die Testenden Belege, erkennen sie neue Revisionen und respektieren sie die Freigabegrenze? Solche Beobachtungen ergänzen Modellkennzahlen; sie beweisen noch kein Verhalten im späteren Alltag.
Nach Änderungen gehören bekannte Fehler in Regressionstests: wiederholte Prüfungen, ob frühere Probleme erneut auftreten. Neue, bisher ungesehene Fälle verhindern, dass man nur noch auf ein bekanntes Testset optimiert.
Bei größeren Testmengen kann LLM-as-a-Judge helfen – ein Large Language Model (großes Sprachmodell), das als automatisierter Bewerter eingesetzt wird: Ein zweites Sprachmodell bewertet Antworten etwa auf Quellentreue oder Vollständigkeit. Seine Urteile müssen an fachkundigen Bewertungen kalibriert werden. Fehlt dem Prüfmodell selbst die maßgebliche Sonderregel, kann es denselben Fehler übersehen. Kritische Fälle benötigen weiterhin fachkundige Prüfung. [7]
Der Betrieb verändert den Prüfgegenstand
Selbst wenn diese erste Prüfung überzeugend ausfällt, bleibt ihre Aussage zeitlich begrenzt. Eine neue Arbeitsanweisung, andere Nutzerfragen oder ein geänderter Suchindex können die Qualität eines zuvor geprüften Chatbots verändern. Frühere Testwerte gelten dann nicht automatisch weiter. Besonders heikel sind stille Änderungen: Nutzer bemerken oft nur eine andere Antwortqualität, nicht deren Ursache.
Zwei unterschiedliche Veränderungen sind zu beobachten: Data Drift liegt etwa vor, wenn sich die Verteilung der Nutzerfragen auf neue Materialtypen verschiebt. Model Drift bezeichnet Veränderungen des Modellverhaltens oder seiner Leistung gegenüber dem geprüften Zustand. Daneben braucht es Change Monitoring, also die Überwachung dokumentierter Änderungen an Quellen, Suchindex, Konfiguration und Modellversion. Eine geänderte Arbeitsanweisung ist noch keine Modelldrift, kann aber die Antwortqualität beeinflussen. Ausschlaggebend bleibt, ob das Gesamtsystem für den erlaubten Zweck weiterhin ausreichend funktioniert. [6] Die Verfahren zur Erkennung und Reaktion werden in einem späteren Vertiefungsartikel erklärt (Artikel ausstehend).
Das Qualitätsmonitoring nutzt Stichproben, Testfälle und bei geklärten Datenschutzbedingungen technische Antwortspuren (Traces): Welche Version wurde gefunden und worauf stützte sich die Antwort? Ein Trace kann helfen, einen Retrieval-Fehler von einer fehlerhaften Antwortzusammenfassung zu unterscheiden. Er ist aber kein Ersatz für die fachliche Beurteilung.
- Signale erfassen: bestätigte Fehlantworten, schwache Quellenbezüge, neue Fragetypen und relevante Dokument-, Modell- oder Indexänderungen.
- Vorfälle einordnen: Bei einem Fehler im Incident Management Ursache, Schwere und mögliche Auswirkungen auf bereits bearbeitete Fälle prüfen; kritische Vorgänge gegebenenfalls eskalieren.
- Gezielt korrigieren: Dokumente, Suchlogik, Systemanweisungen, Berechtigungen oder den erlaubten Nutzungsbereich anpassen – mit dokumentierter Änderung.
- Erneut testen: Betroffene Golden-Set-Fälle, Regressionstests und neue kritische Beispiele durchführen; nur bei tragfähigem Ergebnis die Änderung weiter nutzen.
Fehler sollten mit wenigen Klicks meldbar sein; bei möglichen Qualitäts- oder Sicherheitsfolgen kann die Meldung verpflichtend werden. Nicht jede Antwort muss bewertet werden – das erzeugt leicht Routineklicks statt brauchbarer Hinweise. Fachkundige Stichproben, Nutzerfeedback und klare Eskalation ergänzen sich. [2] Erst die fachliche Prüfung einer Meldung bestimmt, was korrigiert wird. Ergeben sich wiederholt dieselben Fehler, wandern sie in das Golden Set und werden nach jeder relevanten Änderung erneut geprüft.
Für Auswertungen sind Zugriffe, Datenminimierung und Vertraulichkeit zu klären. Auch Verantwortliche, Reaktionszeiten und der Rückfall auf Originaldokumente bei Ausfällen gehören zum Betrieb.
Stichproben, Quellenpflege, LLM-Prüfung und Nachtests gehören in die Gesamtkostenbetrachtung (Total Cost of Ownership, TCO). Bei einem kleinen Chatbot können regelmäßige Kontrollen und Dokumentpflege einen erheblichen Teil des Betriebsaufwands ausmachen, selbst wenn die Modellabfragen günstig sind. Die Bewertung solcher Lebenszykluskosten folgt in einem geplanten Fachbeitrag (Artikel ausstehend).
Woran sich der Chatbot messen lassen muss
Antwortqualität allein entscheidet außerdem noch nicht, ob sich der Chatbot lohnt. Der Vergleich beginnt beim bestehenden Verfahren: Die betriebliche Baseline ist die heutige Dokumentensuche mit anschließendem Qualitäts- und Freigabeprozess. Der Chatbot soll Suche und Verständnis erleichtern, ohne diese Freigabe zu verändern.
Eine verbesserte Volltextsuche mit gepflegten Revisionen und Filtern ist eine reale Nicht-KI-Alternative und möglicherweise mit weniger Kontrollaufwand verbunden. Sie liefert dafür keine frei formulierte Zusammenfassung und kann bei komplexen Fragen mehr Lese- und Suchaufwand erfordern.
Verglichen werden Suchzeit, Fehlerfolgen, Prüf- und Pflegeaufwand bei gleicher Aufgabe. Eine frühe Zeitersparnis-Schätzung kann als Anker (Anchoring) spätere Berechnungen verzerren. Der Prozess-PoC untersucht zunächst, wie sich Fachleute mit dem Chatbot durch den Prüfablauf bewegen und wo zusätzliche Arbeit entsteht. Belastbare Aussagen zur Wirkung im Betrieb erfordern später einen eigenen Pilot.
Einzelne Mechanismen wie Automation Bias werden in weiteren Beiträgen des fachlichen Lernpfads zu psychologischen Biases bei KI- und Datenvorhaben vertieft (Artikel ausstehend).
Entscheidung für den Qualitätsfall
Das Chatbot-Beispiel in der KI-Vorhabenprüfung zeigt, wie die nächste Entscheidung in drei Ständen dokumentiert werden kann. Die Arbeitsprobe und die Nachtests sind fiktive Fortsetzungen des Falls.
Zurück zu Antwort A (Prozess-PoC) oder Antwort B (zuerst Fehlerkorrektur): Der Offline-Test ist bei Routinefragen vielversprechend, zeigt aber zwei Fehler in der kritischen Fallgruppe. Welche Unsicherheit sollte der nächste begrenzte Schritt klären?
Ich würde Antwort A wählen, sofern sich die Arbeitsprobe vollständig von echten Freigaben trennen lässt. Zunächst möchte ich wissen, ob sich der vorgesehene Prüfablauf mit einem Chatbot überhaupt durchführen lässt: Finden Fachleute die notwendigen Originalbelege, wo müssen sie Antworten korrigieren, und an welcher Stelle verursacht das System zusätzliche Arbeit? Eine aufwendige Optimierung einzelner Sonderfälle wäre schlecht priorisiert, wenn sich der gesamte Ansatz schon in einer solchen Arbeitsprobe als unpraktikabel erweist. Die bekannten Fehler bleiben als bewusste Stresstests erhalten, ohne irgendeine echte Chargenentscheidung zu berühren.
Der Proof of Concept (PoC) nutzt dafür abgeschlossene, fachlich aufbereitete Qualitätsfälle in einer separaten Testumgebung (Sandbox). Zwei erfahrene Qualitätsfachleute spielen den vorgesehenen Ablauf durch; die fachlich geprüften Fallauflösungen und Bewertungen der Chatbot-Antworten werden ihnen vor dem jeweiligen Durchlauf nicht angezeigt. Sie dokumentieren Rückfragen, Belegprüfungen, Korrekturen und Zeitaufwand. Neben den bekannten Fehlern werden neue Fälle verwendet, damit die Prüfung nicht bloß die Erinnerung an frühere Antworten misst. Bekannte Fehlerfälle testen insbesondere den Kontroll- und Eskalationsweg; daraus wird keine Fehlererkennungsquote abgeleitet. Aktuelle Chargen und operative Freigaben bleiben außerhalb der Testumgebung. Ein PoC kann solche eng abgegrenzten Machbarkeitsfragen untersuchen; ein späterer Pilot würde eine weiter entwickelte Lösung unter begrenzten realen Betriebsbedingungen prüfen. [8]
Die fünf Prüffelder liefern die Gegenprobe zu A:
- Informationsstand: An abgeschlossenen Fällen prüfen die Fachleute mit gültigen Dokumentständen, welche Regeln gefunden werden und wo die Suche relevante Informationen auslässt.
- Antwort & Beleg: Die beiden bekannten Fehler dienen als dokumentierte Stresstests. An zusätzlich nicht vorab aufgelösten Fällen lässt sich qualitativ beobachten, ob unvollständige Belege erkannt und anhand der Originale korrigiert werden. Weil nur zwei Fachleute beteiligt sind und einzelne Fehler bereits bekannt sind, lässt sich daraus nicht ableiten, wie zuverlässig spätere Nutzer solche Fehler erkennen würden.
- Grenzverhalten: Die acht korrekt bearbeiteten Grenzfragen sind Teil der 60 Offline-Fälle, kein weiterer Test. In der Arbeitsprobe wird beobachtet, ob bei Freigabefragen weiterhin an die zuständige Stelle verwiesen und bei fehlenden Angaben nachgefragt wird.
- Berechtigung & Kontrolle: Geprüft wird, ob die später zuständigen Fachleute die erforderlichen Kenntnisse, Zugriffsrechte, Entscheidungsbefugnisse sowie ausreichend Zeit und Kapazität haben, Antworten anhand der Originalunterlagen zu hinterfragen und nötigenfalls zurückzuweisen. Im PoC werden diese Voraussetzungen zunächst anhand abgeschlossener Fälle erprobt; eine operative Freigabe ist damit nicht verbunden.
- Betriebliche Eignung: Beobachtet werden Verständlichkeit, erforderliche Prüfschritte, Fehlerbilder und zusätzlicher Zeitaufwand. Das zeigt erste Prozesshindernisse und technische Voraussetzungen. Wie normale Beschäftigte im Alltag handeln und ob der Chatbot gegenüber der Baseline wirtschaftlich nützt, bleibt offen.
Was würde ich nach dem PoC entscheiden? Lassen sich Belege nachvollziehbar prüfen, kritische Ausgaben im Versuch erkennen und der Kontrollweg praktikabel einhalten, lohnt die gezielte Behebung der technischen Fehler mit neuen Regressionstests und erst danach die Vorbereitung eines Piloten mit repräsentativeren Nutzern. Scheitert bereits der kontrollierte Prüfablauf, würde ich die Lösung eingrenzen, die Dokumentensuche als Alternative prüfen oder das Vorhaben nicht in dieser Form weiterführen. Antwort B hätte Vorrang, wenn die bekannten Fehler den Erkenntniswert der Arbeitsprobe so stark begrenzen, dass eine technische Korrektur zuerst notwendig ist. Fehlen dagegen gültige Referenzunterlagen oder kann die Prüfung nicht von operativen Freigaben getrennt werden, ist weder Antwort A noch Antwort B in der beschriebenen Form sinnvoll: Zuerst müssen die Voraussetzungen hergestellt werden (Voraussetzungen zuerst); ist das nicht vertretbar möglich, kommt auch ein Stop infrage. Auch nach A müssen die bekannten kritischen Fehler vor einem betrieblichen Pilot behoben und erneut geprüft werden. Änderungen an der Suche erfordern zudem eine neue Beurteilung der PoC-Befunde; eine erfolgreiche Arbeitsprobe für die alte Version ist keine automatische Freigabe für die geänderte Version.
Damit bleibt auch die Ausgangsfrage eindeutig beantwortet: Auf die ursprüngliche Frage zur Chargenfreigabe darf der bislang auf Stufe 1 begrenzte Assistent weiterhin nur Fundstellen nennen und an die zuständige Stelle verweisen.
Antworten sind für den Betrieb erst dann verlässlich genug, wenn ihre Qualität für den vorgesehenen Gebrauch belegt ist und die realen Kontrollwege nachweislich funktionieren. Der Prozess-PoC beantwortet hiervon nur eine eng begrenzte Vorfrage. Ob der Chatbot gegenüber einer gepflegten Dokumentensuche zusätzlichen Nutzen bei vertretbaren Prüf-, Betriebs- und Fehlerkosten schafft, muss später separat nachgewiesen werden.
Zusammenfassung
Für die betriebliche Nutzung zählen neben richtigen Antworten auch gültige Informationen, Grenzverhalten, menschliche Kontrolle und tatsächliche Verwendung.
Ein Golden Set prüft Routine-, Sonder- und Grenzfälle; Suchqualität, Groundedness und fachliche Vollständigkeit bleiben getrennte Maßstäbe. Eine kontrollierte Arbeitsprobe mit abgeschlossenen Fällen kann erste Hindernisse im Prüfablauf sichtbar machen. Erst ein späterer Pilot kann die Verwendung und Wirkung unter betrieblichen Bedingungen untersuchen. Bekannte kritische Fehler müssen zuvor behoben und erneut getestet werden; Monitoring und Regressionstests begleiten den späteren Betrieb.
Quellen
[1] National Institute of Standards and Technology (NIST): Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile, NIST AI 600-1, Juli 2024, Abschnitte 2.2 (Confabulation) und 2.7 (Human-AI Configuration / Automation Bias). https://doi.org/10.6028/NIST.AI.600-1
[2] National Institute of Standards and Technology (NIST): AI Risk Management Framework (AI RMF 1.0), NIST AI 100-1, Januar 2023, insbesondere MAP 1.1, MAP 3.3 und MAP 3.5 (Nutzungskontext und Aufsicht) sowie MANAGE 4.1–4.2 (Feedback und laufende Verbesserung). https://doi.org/10.6028/NIST.AI.100-1
[3] Microsoft: Develop a RAG Solution on Azure – Large language model end-to-end evaluation, Azure Architecture Center, Abschnitte zu Groundedness, Completeness, Relevance und Correctness; geprüft 21.10.2026. https://learn.microsoft.com/en-us/azure/architecture/ai-ml/guide/rag/rag-llm-evaluation-phase
[4] OWASP GenAI Security Project: LLM09:2025 Misinformation, Abschnitt „Prevention and Mitigation Strategies“. https://genai.owasp.org/llmrisk/llm092025-misinformation/
[5] Google Cloud: Prepare your evaluation dataset, technische Dokumentation zur Gen-AI-Evaluation, Felder prompt, response und reference (optionale „ground truth“/„golden answer“); geprüft 21.10.2026. https://docs.cloud.google.com/gemini-enterprise-agent-platform/models/evaluation-dataset
[6] NIST: AI RMF Playbook – Measure, insbesondere MEASURE 1.2 (Änderungen und Metriken), 2.1–2.3 (Testsets, fachkundige und realitätsnahe Prüfung) und 2.4 (Produktionsmonitoring); geprüft 21.10.2026. https://airc.nist.gov/airmf-resources/playbook/measure/
[7] Amazon Web Services (AWS): Evaluating quality and reliability in generated outputs, AWS Prescriptive Guidance, Abschnitt „Model-based evaluation“ zur Nutzung, Kalibrierung und den Grenzen von LLM-as-a-Judge; geprüft 21.10.2026. https://docs.aws.amazon.com/prescriptive-guidance/latest/gen-ai-lifecycle-operational-excellence/dev-experimenting-quality.html
[8] Australian Government, Digital Transformation Agency: Guidance for AI proof of concept to scale – AI transition stages and dimensions, Abschnitte „PoC vs pilot vs production“ und „Business process“, geprüft 21.10.2026. https://www.digital.gov.au/policy/ai/AI-POC-to-scale/ai-transition-stages-and-dimensions
Einseitige Zusammenfassung herunterladen (PDF · 1 Seite)
Fachlich passende Artikel
Weiter im Facharchiv
Architektur & Machbarkeit · Alle Fachbeiträge · Kategorien im Überblick