Ein KI-Modell liefert überzeugende Ergebnisse, die beteiligten Fachleute halten den Ansatz für vielversprechend und die nächste Projektphase scheint greifbar. Trotzdem kann die Grundlage für eine weitere Investition erhebliche Schwächen haben. Vielleicht wurden die falschen Fälle untersucht. Vielleicht misst die verwendete Kennzahl nur einen Teil dessen, worauf es später ankommt. Oder die Projektgruppe verbindet mit dem technischen Erfolg einen wirtschaftlichen Nutzen, den bislang niemand nachgewiesen hat.
Im vorherigen Beitrag haben wir am Beispiel von Steinbach Metalltechnik betrachtet, wie selbst ein kompetentes Team durch bestätigende Informationen, frühe Schätzungen und unvollständigen Wissensaustausch zu einer einseitigen oder verzerrten Bewertung gelangen kann. Solche menschlichen Urteilsverzerrungen sind ein wichtiger Teil des Problems. Wer sie jedoch als Erklärung für jede fragwürdige KI-Entscheidung heranzieht, übersieht andere Fehlerquellen.
Für die nächste Entscheidung macht es einen erheblichen Unterschied, ob das Team voreingenommen urteilt, der Test ungeeignet ist oder das Vorhaben wirtschaftlich nicht trägt. Wie lässt sich erkennen, wo die Schwäche tatsächlich liegt – und welche Gegenprüfung hilft weiter?
Steinbachs erster PoC: 95 % erkannt
Wir kehren zu Steinbach Metalltechnik zurück, unserem fiktiven Automobilzulieferer mit rund 250 Mitarbeitenden. Das Unternehmen untersucht, ob eine kamerabasierte KI-Assistenz die überwiegend manuelle Sichtprüfung metallischer Präzisionsbauteile verbessern kann. Die Software soll auffällige Oberflächenstellen markieren, die das Prüfpersonal anschließend beurteilt.
Steinbach beauftragt einen externen Anbieter mit einem begrenzten Proof of Concept (PoC), um ausgewählte Oberflächenabweichungen unter definierten Bedingungen zu erkennen. Die spätere Produktionseignung ist noch nicht Gegenstand des Versuchs. Im zurückgehaltenen Testdatensatz erreicht das Machine-Learning-Modell (ML-Modell) eine Sensitivität von 95 %. Es erkennt damit 95 % der dort als nichtkonform bewerteten Teile. Die Projektgruppe ist vorläufig zufrieden. Die Metrikübersicht aus dem Vorgängerartikel erklärt diese Kennzahl.
Bei der Vorbereitung des nächsten Versuchs wird die Grenze dieser Prüfung wichtig: Die Testdaten stammen aus einem begrenzten Fertigungszeitraum. Ihre Übertragbarkeit wurde noch nicht gesondert untersucht. Eine erste Prozessbetrachtung zeigt keinen offensichtlichen Ausschlussgrund für eine weitere technische Untersuchung; eine Pilotfreigabe steht noch nicht an.
Das verfügbare Budget reicht zunächst nur für eine zusätzliche technische Untersuchung. Welche würden Sie priorisieren?
- A – Robustheit verbessern: Das Modell mit weiteren Aufnahmen trainieren und anschließend erneut bewerten.
- B – Aussagekraft prüfen: Einen unabhängigen Test mit einer am vorgesehenen Einsatz orientierten Stichprobe und gesonderten schwierigen Varianten durchführen.
- C – Fehlerfolgen begrenzen: Den Erkennungsschwellenwert verändern und die Auswirkungen auf übersehene Fehler und Nachprüfaufwand untersuchen.
Für alle drei Maßnahmen gibt es gute fachliche Gründe. Doch ihre Reihenfolge ist keineswegs beliebig. Wer die falsche Maßnahme zuerst wählt, kann Zeit und Budget investieren, ohne der eigentlichen Entscheidung näherzukommen.
Behalten Sie Ihre vorläufige Wahl im Kopf. Wir kommen darauf zurück.
Kurzfassung für Entscheider öffnen
Kernaussage: Problematische KI-Entscheidungen können durch menschliche Urteilsverzerrungen, Datenfehler, ungeeignete Modellbewertungen, unrealistische Projektannahmen oder fehlende betriebliche Absicherung entstehen. Die Ursachen können zusammenwirken, verlangen aber unterschiedliche Gegenprüfungen.
Fachliche Grundlage: Forschung zu KI-Bias und zum Machine-Learning-Lebenszyklus untersucht Fehlerquellen bei menschlicher Bewertung, Datengewinnung, Modellentwicklung und Anwendung. Risikomanagementansätze ergänzen die organisatorische und betriebliche Perspektive.
Größte Unsicherheit: Ein gutes Testergebnis oder eine Abweichung im Betrieb zeigt für sich genommen nicht, ob die Ursache in den Daten, der Modellbewertung, menschlichen Fehleinschätzungen, wirtschaftlichen Annahmen oder organisatorischen Bedingungen liegt. Die fünf im Artikel erläuterten Cluster möglicher Fehlerquellen dienen der Orientierung und sind keine wissenschaftlich festgelegte, überschneidungsfreie Klassifikation.
Praktische Konsequenz: Bevor weitere Modelloptimierungen oder Investitionen beschlossen werden, sollten die plausiblen Fehlerquellen systematisch eingegrenzt werden: Sind die Daten repräsentativ? Wurde mit geeigneten Metriken und unter realistischen Bedingungen getestet? Sind Nutzenannahmen und betriebliche Voraussetzungen belastbar? Erst aus den Befunden sollten gezielte Gegenprüfungen und der nächste Projektschritt abgeleitet werden.
1. Warum wir bei Fehlern genauer unterscheiden müssen
Die 95 % aus Steinbachs erstem PoC sind zunächst eine Messung. Ob daraus eine tragfähige Entscheidungsgrundlage wird, hängt von mehreren Voraussetzungen ab.
Haben die beteiligten Fachleute das Ergebnis unvoreingenommen beurteilt? Waren die untersuchten Bauteile für den geplanten Einsatz geeignet ausgewählt? Wurde die Modellleistung mit den richtigen Kennzahlen bewertet? Und selbst wenn diese Fragen positiv beantwortet werden: Verbessert die KI den Prüfablauf so weit, dass sich der zusätzliche Aufwand rechtfertigt?
Jede dieser Fragen kann eine andere Schwäche aufdecken. Eine kritische Teamdiskussion verbessert möglicherweise die Bewertung vorhandener Informationen, korrigiert aber keine falschen Referenzdaten. Zusätzliche Trainingsbilder helfen wenig, wenn die Wirtschaftlichkeitsrechnung von einem Prüfablauf ausgeht, der später gar nicht umgesetzt werden kann.
Unter dem Begriff Bias werden verschiedene Arten systematischer Verzerrungen verstanden. Das amerikanische National Institute of Standards and Technology (NIST) unterscheidet unter anderem menschliche, statistisch-technische und systemische Ursachen. Forschung zum Machine-Learning-Lebenszyklus zeigt außerdem, wie Fehler bereits bei Datenauswahl, Messung, Modellbildung und Anwendung entstehen können. [1][2]
Bei der Beurteilung eines KI-Vorhabens müssen wir darüber hinaus wirtschaftliche und betriebliche Fehler berücksichtigen. Nicht jeder davon ist ein Bias im wissenschaftlichen Sinn.
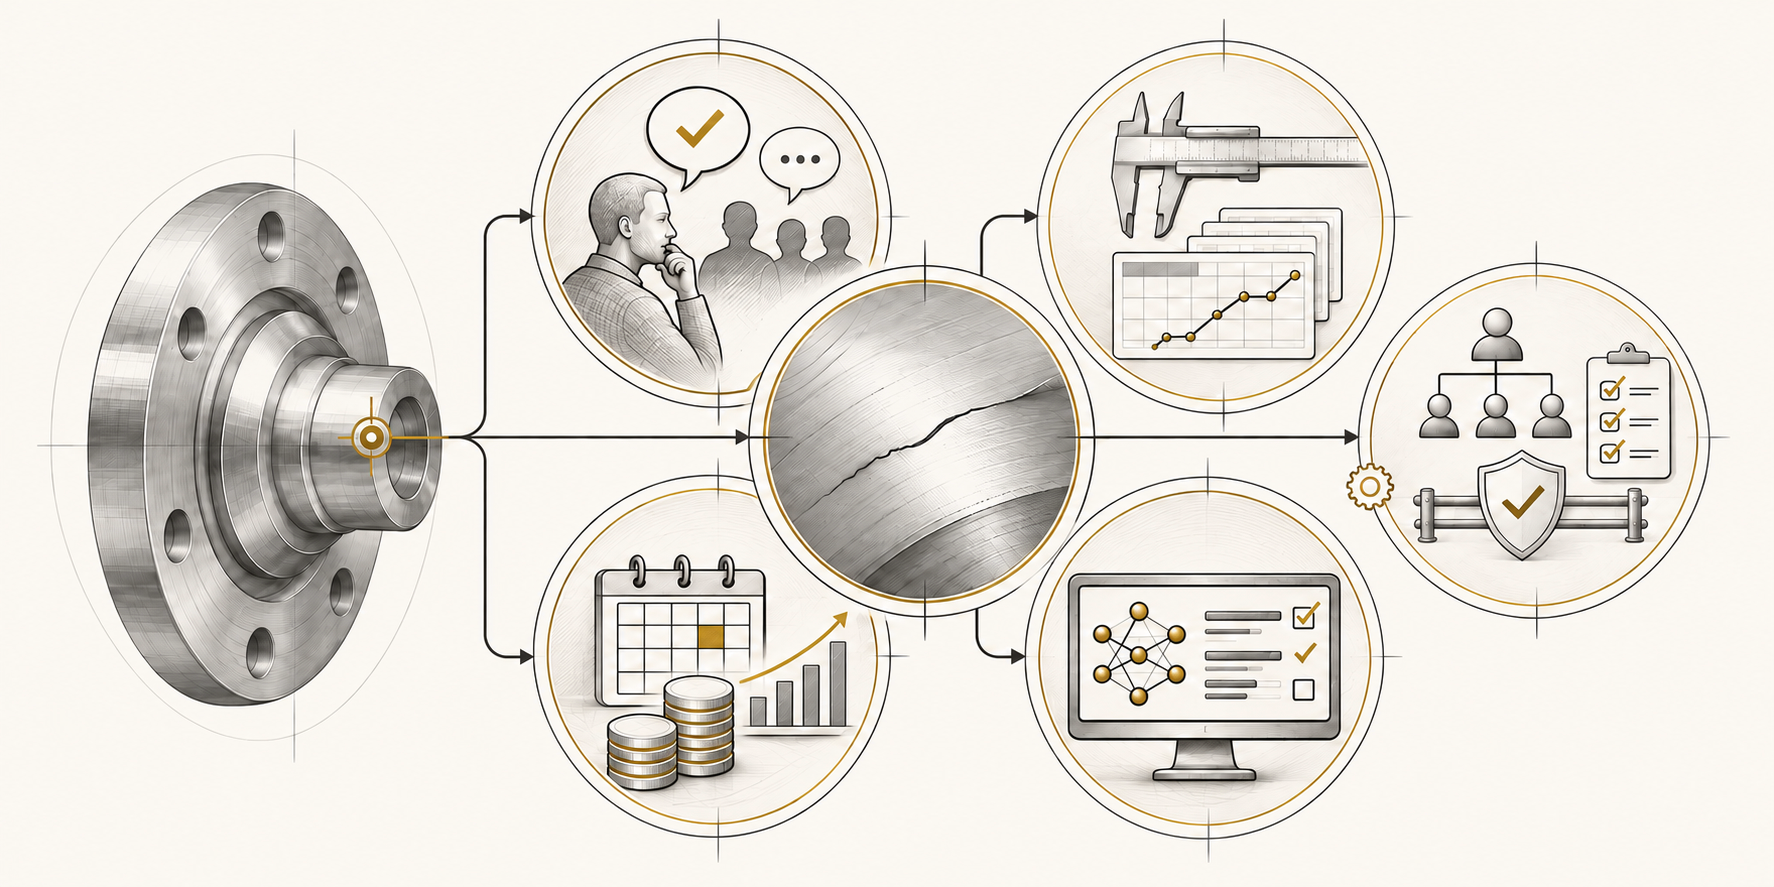
Für die praktische Einordnung bietet sich deshalb eine Unterscheidung in fünf Fehlerbereiche an. Sie ist keine zusätzliche Freigabemethode und erhebt keinen Anspruch auf vollständige Trennschärfe. Ihr Zweck ist, die mögliche Fehlerursache so weit einzugrenzen, dass sich daraus eine sinnvolle Gegenprüfung ableiten lässt.

Diese Übersicht hilft, Fehler einzuordnen und passende Gegenprüfungen zu wählen. Die folgenden Detailartikel vertiefen die Mechanismen und Maßnahmen überwiegend am Steinbach-Fall.
2. Fünf Fehlerbereiche – und was sie für Steinbach bedeuten
Menschliches Urteil und Gruppendynamik: Welche Informationen bekommen Gewicht?
Im ersten Beitrag über Steinbach haben wir gesehen, wie eine frühe Präferenz für die KI-Lösung die Diskussion beeinflussen kann. Positive Vorführungsergebnisse erhalten viel Aufmerksamkeit, während fehlende Vergleichsdaten vertagt werden. Eine erste Einsparschätzung wird zum Ausgangspunkt späterer Berechnungen, und Erfahrungen einzelner Beschäftigter erreichen die Entscheidungsrunde möglicherweise zu spät.
Dahinter stehen unterschiedliche Mechanismen: Beim Confirmation Bias werden bestätigende Informationen bevorzugt gesucht oder gewichtet. [3] Beim Anchoring beeinflusst ein früher Zahlenwert spätere Schätzungen. [4] In Gruppendiskussionen können gemeinsam bekannte Informationen dominieren, obwohl einzelne Beteiligte über wichtige zusätzliche Erkenntnisse verfügen. [5] Die psychologische Forschung hat diese Effekte breit untersucht; hier zählt ihre Relevanz für Entscheidungen in KI-Vorhaben.
Steinbachs vorläufige Zufriedenheit mit den 95 % ist deshalb noch kein Problem. Entscheidend wird, wie die Projektgruppe reagiert, wenn neue Informationen das bisherige Ergebnis infrage stellen.
Würde eine positive Kennzahl genügen, um den nächsten Versuch zu begründen, während kritische Befunde erst nach umfangreicher zusätzlicher Untersuchung berücksichtigt würden, entstünden unterschiedliche Belegmaßstäbe.
Eine geeignete Gegenmaßnahme setzt daher bei der Begründung der Empfehlung an. Welche Annahmen tragen sie? Welche Beobachtungen fehlen? Welcher neue Befund würde die Einschätzung verändern? Hilfreich ist, diese Fragen zunächst unabhängig beantworten zu lassen und besondere Fachinformationen vor der gemeinsamen Bewertung einzuholen.
Dabei sollten wir nicht jede abweichende Meinung als Bias deuten. Ein Qualitätsverantwortlicher kann aus guten Gründen strengere Anforderungen an übersehene Fehler stellen als die Produktionsleitung, die vor allem Entlastung erwartet. Der Unterschied liegt möglicherweise in den verantworteten Folgen und muss nicht auf einer Urteilsverzerrung beruhen.
Doch auch ein Team, das vollkommen ausgewogen diskutiert, kann auf einer fehlerhaften Grundlage entscheiden.
Vertiefung: Confirmation Bias, Anchoring und weitere Denkfehler in KI-Entscheidungen. Artikel ausstehend.
Daten, Messung und Analyse: Was wurde überhaupt untersucht?
Der externe Anbieter hat den PoC auf die vereinbarte Machbarkeitsfrage zugeschnitten. Steinbach hätte deshalb bereits vor dem Versuch klären und dokumentieren müssen, welche Aussage die begrenzte Fallauswahl erlaubt. Für eine spätere Pilotentscheidung gelten jedoch weitergehende Anforderungen: Wurden überwiegend häufig vorkommende Bauteilvarianten bei stabilen Aufnahmebedingungen untersucht, könnten seltene Oberflächenzustände oder anspruchsvolle Grenzfälle fehlen.
Eine solche systematische Verzerrung durch die Fallauswahl wird als Selection Bias bezeichnet.
Der begrenzte PoC ist dadurch nicht automatisch fehlerhaft. Problematisch wäre, seinen Befund als Nachweis für Produktionsbedingungen zu verwenden, die er nicht abgedeckt hat. Die Übertragungsgrenze muss daher vor dem nächsten Beschluss ausdrücklich geprüft werden.
Hinzu kommt die Frage, woran das Modell gemessen wird. Bei Steinbach muss festgelegt sein, welche Oberflächenabweichungen als nichtkonform gelten. Wenn Grenzfälle uneinheitlich gekennzeichnet werden, hängt die gemessene Modellleistung möglicherweise von einer unzuverlässigen Referenz ab. Eine Untersuchung zur industriellen Oberflächenprüfung von Holzbauteilen beschreibt den Zusammenhang zwischen Fehlerdefinition, Datenkennzeichnung und Aufnahmebedingungen. [6]
Auch eine scheinbar saubere Trennung von Trainings- und Testdaten verdient Aufmerksamkeit. Wenn Informationen aus dem Test bereits bei der Entwicklung oder Auswahl des Modells verwendet wurden, kann die spätere Evaluation zu günstig ausfallen. Dieses Problem wird als Data Leakage bezeichnet.
Zur Vorbeugung dieser Fehler helfen unterschiedliche Prüfungen. Eine unzureichende Fallauswahl verlangt die Untersuchung fehlender Varianten. Uneinheitliche Bewertungen erfordern klare Referenzkriterien. Bei möglichem Data Leakage muss nachvollzogen werden, welche Daten und Informationen in welcher Entwicklungsphase verwendet wurden.
Einfach weitere Bilder zum Training hinzuzufügen wäre bei keiner dieser Ursachen automatisch die richtige Antwort. Gerade darin liegt der Nutzen der Unterscheidung: Mehr Daten beheben nicht zwangsläufig einen Fehler in der Datengrundlage.
Vertiefung: Selection Bias, Survivorship Bias und Messfehler erkennen. Artikel ausstehend.
Modell, Evaluation und Anwendung: Was sagen die 95 % tatsächlich aus?
Angenommen, Steinbach hat geeignete Testfälle und verlässliche Referenzbewertungen verwendet. Damit ist eine wichtige Voraussetzung erfüllt, aber die Kennzahl muss weiterhin richtig interpretiert werden.
Die Sensitivität beschreibt, welchen Anteil der tatsächlich nichtkonformen Teile das Modell erkannt hat. Sie lässt offen, wie viele zulässige Teile ebenfalls als nichtkonform markiert werden. Für die geplante KI-Assistenz ist das relevant, weil jede zusätzliche Markierung möglicherweise eine Nachprüfung auslöst.
Auch die fünf Prozent übersehenen Fehler sind nicht ohne Weiteres zu bewerten. Welche Fehlerarten betrifft das? Welche Folgen hätten sie? Und wie zuverlässig ist der gemessene Anteil, wenn im Test vielleicht nur wenige nichtkonforme Teile enthalten waren?
Die Leistungsbewertung muss deshalb zur vorgesehenen Entscheidung passen. Eine einzelne Erfolgskennzahl kann wichtige Unterschiede zwischen Fehlerarten, Grundhäufigkeiten und betrieblichen Folgen verdecken.
Ein weiterer Punkt betrifft die Übertragbarkeit. Unterscheiden sich die späteren Aufnahmen von den Entwicklungs- und Testbedingungen, kann sich das Modell anders verhalten. Diese Veränderung der Datenbedingungen wird als Distribution Shift bezeichnet. Wie anspruchsvoll reale industrielle Aufnahmebedingungen sein können, zeigt eine Untersuchung unüberwachter Anomalieerkennung mit sechs visuellen Prüfaufgaben aus automobilen Montagelinien. [7]
Eine geeignete Gegenprüfung untersucht daher die Modellleistung unter relevanten Bedingungen und berücksichtigt diejenigen Kennzahlen, die für die Prüfaufgabe tatsächlich bedeutsam sind.
Erst anschließend lässt sich beurteilen, ob ein zusätzlicher Trainingsschritt oder eine andere Erkennungsschwelle hilft. Wird die Schwelle beispielsweise so verändert, dass mehr Auffälligkeiten markiert werden, können dadurch zwar weniger Fehler übersehen werden, gleichzeitig kann aber der Nachprüfaufwand steigen.
Welche Einstellung sinnvoll ist, entscheidet sich letztlich an den Folgen im Prüfprozess. Technische Modellgüte und betriebliche Eignung hängen zusammen, beantworten aber unterschiedliche Fragen.
Vertiefung: Modellmetriken, Distribution Shift und Anwendung. Artikel ausstehend.
Projektplanung und Wirtschaftlichkeit: Was wird aus der technischen Leistung im Arbeitsalltag?
Mit einem erfolgreichen technischen Nachweis wächst häufig die Erwartung, dass auch die wirtschaftlichen Ziele erreichbar sind. Bei Steinbach könnte die Projektgruppe beispielsweise annehmen, dass eine hohe Erkennungsleistung einen erheblichen Teil der bisherigen Sichtprüfung überflüssig macht.
Dafür liefert die Sensitivität allein keinen Beleg.
Die vorgesehene KI soll zunächst verdächtige Stellen markieren. Ob dadurch Arbeit entfällt, hängt davon ab, wie diese Hinweise genutzt werden. Muss das Prüfpersonal weiterhin jedes Teil betrachten? Werden nur markierte Teile genauer untersucht? Welche zusätzlichen Kontrollen sind notwendig, und welche Kapazität steht dafür zur Verfügung?
Erst wenn der zukünftige Ablauf ausreichend konkret ist, lässt sich der Aufwand mit der heutigen Prüfung vergleichen. Frei werdende Arbeitszeit kann einen relevanten Nutzen darstellen, führt aber nicht zwangsläufig zu entsprechend niedrigeren Personalkosten. Ebenso müssen zusätzliche Ausgaben für Integration, Datenpflege und Betrieb berücksichtigt werden.
Zu optimistische Nutzenannahmen oder unterschätzter Projektaufwand können durch Optimism Bias und Planning Fallacy begünstigt werden. Optimism Bias lässt Vorteile wahrscheinlicher und Risiken kleiner erscheinen, als die Belege rechtfertigen. Bei der Planning Fallacy werden Dauer und Aufwand unterschätzt, etwa weil Nacharbeiten fehlen.
Für die Gegenprüfung ist diese Unterscheidung weniger wichtig als die belastbare Herleitung: Welche Tätigkeiten verändern sich tatsächlich? Welche Kosten entstehen? Welche Annahmen treiben das Ergebnis, und wie empfindlich reagiert die Wirtschaftlichkeit auf ihre Veränderung?
Bei Steinbach gehören außerdem die Alternativen in den Vergleich: eine verbesserte manuelle Sichtprüfung und regelbasierte Bildverarbeitung. Ein wirtschaftlicher Nutzen der KI lässt sich nur sinnvoll beurteilen, wenn die Optionen an vergleichbaren Aufgaben und Folgen gemessen werden.
Vertiefung: Optimism Bias, Planning Fallacy und versunkene Kosten. Artikel ausstehend.
Organisation, Governance und Betrieb: Wer trägt die Entscheidung im laufenden Prozess?
Selbst wenn Steinbach technische Eignung und wirtschaftlichen Nutzen plausibel nachweist, bleibt der spätere Betrieb zu klären.
Wer entscheidet bei widersprüchlichen Hinweisen? Wer überprüft, ob die Erkennungsleistung unter veränderten Bedingungen erhalten bleibt? Und was passiert, wenn wiederholt kritische Oberflächenabweichungen übersehen werden?
Solche Fragen können zunächst nebensächlich erscheinen, solange der PoC im Mittelpunkt steht. Spätestens vor einem betrieblichen Pilot beeinflussen sie jedoch, ob die Lösung kontrolliert eingesetzt werden kann.
Eine menschliche Freigabe ist beispielsweise wenig wert, wenn das Prüfpersonal die zugrunde liegenden Hinweise nicht angemessen beurteilen kann oder im Produktionstakt keine Zeit für die erforderliche Kontrolle bleibt.
Das NIST AI Risk Management Framework behandelt Verantwortlichkeiten, Nutzungskontext, Messung und Risikobehandlung als miteinander verbundene Aufgaben. Es gibt dabei keine starre Reihenfolge vor, die für jedes Vorhaben gleichermaßen geeignet wäre. [8]
Für Steinbach könnte zunächst ein begrenzter Parallelbetrieb sinnvoll sein, in dem die KI Hinweise liefert, während die bestehende Qualitätsprüfung weitergeführt wird. Dabei müssten Fehler dokumentiert, Eingriffsmöglichkeiten geklärt und die Grenzen des Versuchs festgelegt werden.
Welche gesetzlichen Anforderungen zusätzlich gelten, hängt vom konkreten Verwendungszweck und der rechtlichen Einstufung ab. Der Einsatz von KI in einer industriellen Qualitätsprüfung ist nicht automatisch ein Hochrisiko-Anwendungsfall nach dem EU AI Act. [9]
Welche Governance-Fragen bereits vor dem nächsten Schritt geklärt werden müssen und wie sich der Kontrollbedarf je nach Nutzung verändert, vertieft „Wann wird aus einer guten KI-Idee ein Governance-Thema?“. Eine vollständige rechtliche Einordnung konkreter KI-Einsätze ersetzt dieser Beitrag nicht.
Eine solche Prüfung betrifft folglich mehr als eine formale Zuständigkeitsliste. Sie muss zeigen, ob das Unternehmen die technische Leistung unter realen Arbeitsbedingungen tatsächlich beherrschen kann.
3. Wenn sich Fehler gegenseitig verstärken
Die fünf Bereiche lassen sich für die Analyse unterscheiden, im Projektverlauf greifen sie jedoch häufig ineinander.
Stellen wir uns vor, Steinbachs Testdatensatz enthält vor allem einfache Aufnahmebedingungen. Die 95 % erscheinen deshalb günstiger, als es bei anderen relevanten Einsatzbedingungen der Fall wäre. Die Projektgruppe interpretiert die Kennzahl als weitgehend übertragbar und verwendet sie anschließend für eine ambitionierte Entlastungsrechnung.
Darin lägen möglicherweise ein Fehler bei der Datenauswahl, eine zu weitgehende Modellinterpretation und eine wirtschaftliche Fehleinschätzung. Wenn kritische Einwände aufgrund der bestehenden Erfolgserwartung zu wenig Beachtung finden, könnte zusätzlich ein menschlicher Bestätigungsfehler wirken.
Ob diese Fehler tatsächlich vorliegen, wissen wir damit noch nicht. Gerade bei komplexen Vorhaben ist es verlockend, aus einem auffälligen Ergebnis unmittelbar eine plausible Ursache abzuleiten. Doch eine plausible Erklärung bleibt zunächst eine Hypothese.
Das verändert auch den Umgang mit Gegenmaßnahmen. Mehr Training könnte die Modellleistung verbessern, ohne die fehlerhafte Wirtschaftlichkeitsannahme zu korrigieren. Eine neue Wirtschaftlichkeitsrechnung wiederum sagt wenig darüber aus, ob die bisherige Evaluation zuverlässig war.
Die Gegenprüfung muss deshalb dort ansetzen, wo die bisherige Entscheidungsgrundlage möglicherweise nicht trägt.
Eine erste Sichtung der fünf Bereiche sammelt Warnsignale, Belege und Gegenhypothesen. Anschließend bewerten die beteiligten Fachleute, welcher mögliche Ausschlussgrund zuerst zu prüfen ist und welcher Test den nächsten Beschluss mit vertretbarem Aufwand verändern könnte. Ein späteres Arbeitsmaterial kann diese Priorisierung strukturieren, aber kein Expertenurteil ersetzen.
4. Zurück zu den 95 %: Welche Untersuchung hat Vorrang?
Damit kommen wir zur Entscheidung vom Anfang zurück.
Steinbach stand vor der Wahl, das Modell weiter zu trainieren, die Aussagekraft des bisherigen Tests zu untersuchen oder die Erkennungsschwelle zu verändern.
Unter den beschriebenen Voraussetzungen würde ich B priorisieren: die unabhängige Evaluation unter relevanten Einsatzbedingungen.
Der bisherige Test liefert zwar ein positives technisches Signal. Ungeklärt ist aber, wie weit dieses Ergebnis trägt. Mit zusätzlichem Training nach A würden wir möglicherweise bereits eine Schwäche beheben wollen, deren Art und Ausmaß noch gar nicht festgestellt wurden. Eine Schwellenanpassung nach C könnte das Verhältnis zwischen übersehenen Fehlern und zusätzlichen Markierungen verändern, ohne die Unsicherheit über die späteren realen Einsatzbedingungen zu beseitigen. Diese kann auch die wirtschaftliche und organisatorische Bewertung wesentlich beeinflussen.
Für B müsste Steinbach zunächst festlegen, welche Bauteil- und Aufnahmevarianten für den geplanten Einsatz relevant sind. Danach wären unabhängig von der bisherigen Modellauswahl geeignete Testfälle zusammenzustellen und anhand verlässlicher Referenzbewertungen auszuwerten.
Dabei müssen zwei Prüfziele unterschieden werden. Eine am Einsatz orientierte Evaluation schätzt die Leistung unter vorgesehenen Bedingungen ab. Ein gesonderter Stresstest sucht Schwächen bei schwierigen Varianten, deren gehäufte Fälle keine typische Betriebsfehlerrate ergeben. Deutliche Leistungseinbrüche könnten den Pilotumfang einschränken oder Nachbesserungen erfordern.
Auch die Fallzahlen sind wichtig. Ohne zu wissen, wie viele nichtkonforme Teile den gemessenen 95 % zugrunde liegen, lässt sich die statistische Unsicherheit des Ergebnisses nicht angemessen beurteilen.
Die Wahl von B bedeutet deshalb noch keine Pilotfreigabe. Eine kostengünstige Prüfung möglicher wirtschaftlicher oder betrieblicher Ausschlussgründe kann parallel erfolgen.
Unter anderen Voraussetzungen könnte die Entscheidung anders ausfallen. Wäre ein konkretes Robustheitsproblem bereits nachgewiesen, könnte gezieltes Training sinnvoller sein. Würde eine frühe Prozessanalyse ergeben, dass selbst eine hervorragende Modellleistung kaum zusätzliche Wirkung entfaltet, müsste zunächst die Wirtschaftlichkeit beziehungsweise der Lösungsansatz hinterfragt werden.
Eine gute Gegenprüfung liefert somit mehr als neue Daten. Sie hilft zu entscheiden, ob das Vorhaben weitergeführt, verändert oder zunächst grundsätzlich neu bewertet werden sollte. So lässt sich gegebenenfalls Budget für verfrühte Tests oder Optimierungen vermeiden.
5. Wie die Fehlerdiagnose unsere Projektprüfung ergänzt
Im ersten fachlichen Lernpfad haben wir sieben Prüfdimensionen für KI- und Datenvorhaben eingeführt. Sie reichen von Problem und Entscheidung über Alternativen, Daten, Machbarkeit und Verantwortung bis zu Evidenz und Bewertung sowie Nutzen und Wirtschaftlichkeit.
Die fünf Fehlerbereiche ersetzen diese Dimensionen nicht. Sie helfen dabei, innerhalb der jeweils relevanten Dimension mögliche Schwächen der eigenen Bewertung zu erkennen.
Bei Steinbach steht beispielsweise die Dimension Evidenz und Bewertung im Vordergrund. Für sie kann es entscheidend sein, ob die Projektgruppe Gegenbefunde angemessen berücksichtigt, ob die Testdaten geeignet sind und ob die Modellkennzahlen tatsächlich die vorgesehene Nutzung abbilden. Die Wirtschaftlichkeit und betriebliche Verantwortung bleiben als mögliche weitere Entscheidungshindernisse im Blick.
Es wäre wenig hilfreich, daraus eine feste Prüfung aller fünf Fehlerbereiche innerhalb jeder der sieben Dimensionen abzuleiten. Je nach Vorhaben sind manche Fragen früh entscheidend, während andere erst nach einer ersten Klärung sinnvoll untersucht werden können.
Für die praktische Anwendung genügen zunächst vier miteinander verbundene Fragen:
| Schritt | Frage |
|---|---|
| Warnsignal | Welcher konkrete Befund lässt uns an der bisherigen Bewertung zweifeln? |
| Gegenhypothese | Welche alternative Erklärung könnte zutreffen? |
| Gegenprüfung | Welche Untersuchung hilft, die Erklärungen auseinanderzuhalten? |
| Entscheidungsfolge | Welches Ergebnis würde den nächsten Beschluss verändern? |
Diese Fragen ergänzen die sieben Prüfdimensionen um einen gezielten Blick auf mögliche Fehlurteile. Sie helfen, die nächste Untersuchung zu begründen, ohne das gesamte Vorhaben bei jeder neuen Unsicherheit von vorn aufzurollen.
Zusammenfassung
Fünf Fehlerbereiche können die Beurteilung eines KI-Vorhabens beeinflussen:
| Fehlerbereich | Typische Biases / Fehlermechanismen | Was wir hinterfragen sollten |
|---|---|---|
| Menschliches Urteil & Gruppendynamik | Confirmation Bias, Anchoring, verzerrter Informationsaustausch | Werden Evidenz, Einwände und Fachwissen angemessen gewichtet? |
| Daten, Messung & Analyse | Selection Bias, unzuverlässige Referenzbewertungen, Data Leakage | Bilden die untersuchten Fälle die relevante Realität zuverlässig ab? |
| Modell, Evaluation & Anwendung | Distribution Shift, fehlinterpretierte Kennzahlen | Tragen Kennzahlen und Testbedingungen die Aussage über den vorgesehenen Einsatz? |
| Projektplanung & Wirtschaftlichkeit | Optimism Bias, Planning Fallacy | Sind Nutzen, Aufwand und Alternativen nachvollziehbar bewertet? |
| Organisation, Governance & Betrieb | Unklare Verantwortlichkeiten, fehlende Betriebskontrollen | Kann die Lösung im tatsächlichen Arbeitsprozess kontrolliert eingesetzt werden? |
Für Steinbach ist zunächst die Aussagekraft des ersten PoC-Ergebnisses zu klären. Ob daraus ein weiterführender Pilot wird, hängt von den zusätzlichen Befunden, dem erwartbaren Nutzen und den verbleibenden Voraussetzungen ab.
Bessere KI-Entscheidungen entstehen, wenn wir nicht nur Ergebnisse hinterfragen, sondern auch verstehen, woher mögliche Fehler stammen und welche Gegenprüfung unsere Einschätzung tatsächlich verändern kann.
Die folgenden Beiträge vertiefen einzelne Fehlermechanismen. Den Anfang machen Verzerrungen bei der Auswahl von Daten und bei der Betrachtung scheinbar erfolgreicher Fälle. Anschließend folgen weitere kognitive und methodische Fehler, jeweils mit konkreten Möglichkeiten, sie zu erkennen und ihre Auswirkungen auf Entscheidungen zu begrenzen.
Einseitige Zusammenfassung herunterladen (PDF · 1 Seite)
Quellen und Übertragungsgrenzen
[1] Schwartz, R., et al. (2022). Towards a Standard for Identifying and Managing Bias in Artificial Intelligence. NIST SP 1270. Systemische, statistisch-technische und menschliche Bias-Ursachen; keine Grundlage für eine normativ verbindliche Fünf-Bereiche-Taxonomie. https://doi.org/10.6028/NIST.SP.1270
[2] Suresh, H., Guttag, J. (2021). A Framework for Understanding Sources of Harm throughout the Machine Learning Life Cycle. EAAMO 2021. Fehler- und Schadensquellen entlang des ML-Lebenszyklus; nicht unmittelbar auf alle wirtschaftlichen Projektfehler übertragbar. https://doi.org/10.1145/3465416.3483305
[3] Nickerson, R. S. (1998). Confirmation Bias: A Ubiquitous Phenomenon in Many Guises. Review of General Psychology, 2(2), 175–220. Überblick zur selektiven Suche und Interpretation bestätigender Evidenz. https://doi.org/10.1037/1089-2680.2.2.175
[4] Mussweiler, T., Strack, F., Pfeiffer, T. (2000). Overcoming the Inevitable Anchoring Effect: Considering the Opposite Compensates for Selective Accessibility. Personality and Social Psychology Bulletin, 26(9), 1142–1150. Experimentelle Untersuchungen zum Ankereffekt; kein direkter Nachweis für den hier beschriebenen betrieblichen Ablauf. https://doi.org/10.1177/01461672002611010
[5] Stasser, G., Titus, W. (1985). Pooling of Unshared Information in Group Decision Making: Biased Information Sampling During Discussion. Journal of Personality and Social Psychology, 48(6), 1467–1478. Forschung zu geteilten und ungeteilten Informationen in Gruppendiskussionen; keine Untersuchung von KI-Projektteams. https://doi.org/10.1037/0022-3514.48.6.1467
[6] Stephani, H., et al. (2023). Challenges and Approaches When Realizing Online Surface Inspection Systems With Deep Learning Algorithms. Discover Data, 1, Artikel 3. Fehlerdefinition, Datenkennzeichnung und industrielle Bildgewinnung im Kontext von Holzoberflächen; keine quantitativen Aussagen zu Steinbach. https://doi.org/10.1007/s44248-023-00004-w
[7] Carvalho, P., et al. (2024). Detecting Visual Anomalies in an Industrial Environment: Unsupervised Methods Put to the Test on the AutoVI Dataset. Computers in Industry, 163, 104151. Sechs visuelle Prüfaufgaben aus automobilen Montagelinien; keine direkte Leistungsübertragung auf das fiktive Modell. https://doi.org/10.1016/j.compind.2024.104151
[8] Tabassi, E. (2023). Artificial Intelligence Risk Management Framework (AI RMF 1.0). NIST AI 100-1. Kontext, Messung, Verantwortlichkeit und Risikobehandlung. Freiwilliges Framework, keine gesetzliche Freigabevorschrift. https://doi.org/10.6028/NIST.AI.100-1
[9] Europäische Union. Verordnung (EU) 2024/1689 (AI Act), geändert durch Verordnung (EU) 2026/1744. Die rechtliche Klassifikation ist vom tatsächlichen Verwendungszweck und den einschlägigen Bestimmungen abhängig. Aus dem fiktiven Fall lässt sie sich nicht abschließend ableiten. https://eur-lex.europa.eu/eli/reg/2024/1689 · https://eur-lex.europa.eu/eli/reg/2026/1744/oj
Annahmen und Beispielwerte: Steinbach Metalltechnik, der externe erste PoC, die Sensitivität von 95 % und die dargestellten Untersuchungsoptionen sind hypothetisch. Es werden weder reale Unternehmensdaten noch tatsächlich erzielte Modellergebnisse behauptet. Die Kennzahl ist keine allgemeine Zielschwelle und begründet keine betriebliche Freigabe.
Quellenstand: November 2026.
Fachlich passende Artikel
Weiter im Facharchiv
Zur Kategorie „Entscheidungsarchitektur“ · Alle Fachbeiträge · Alle Themenbereiche