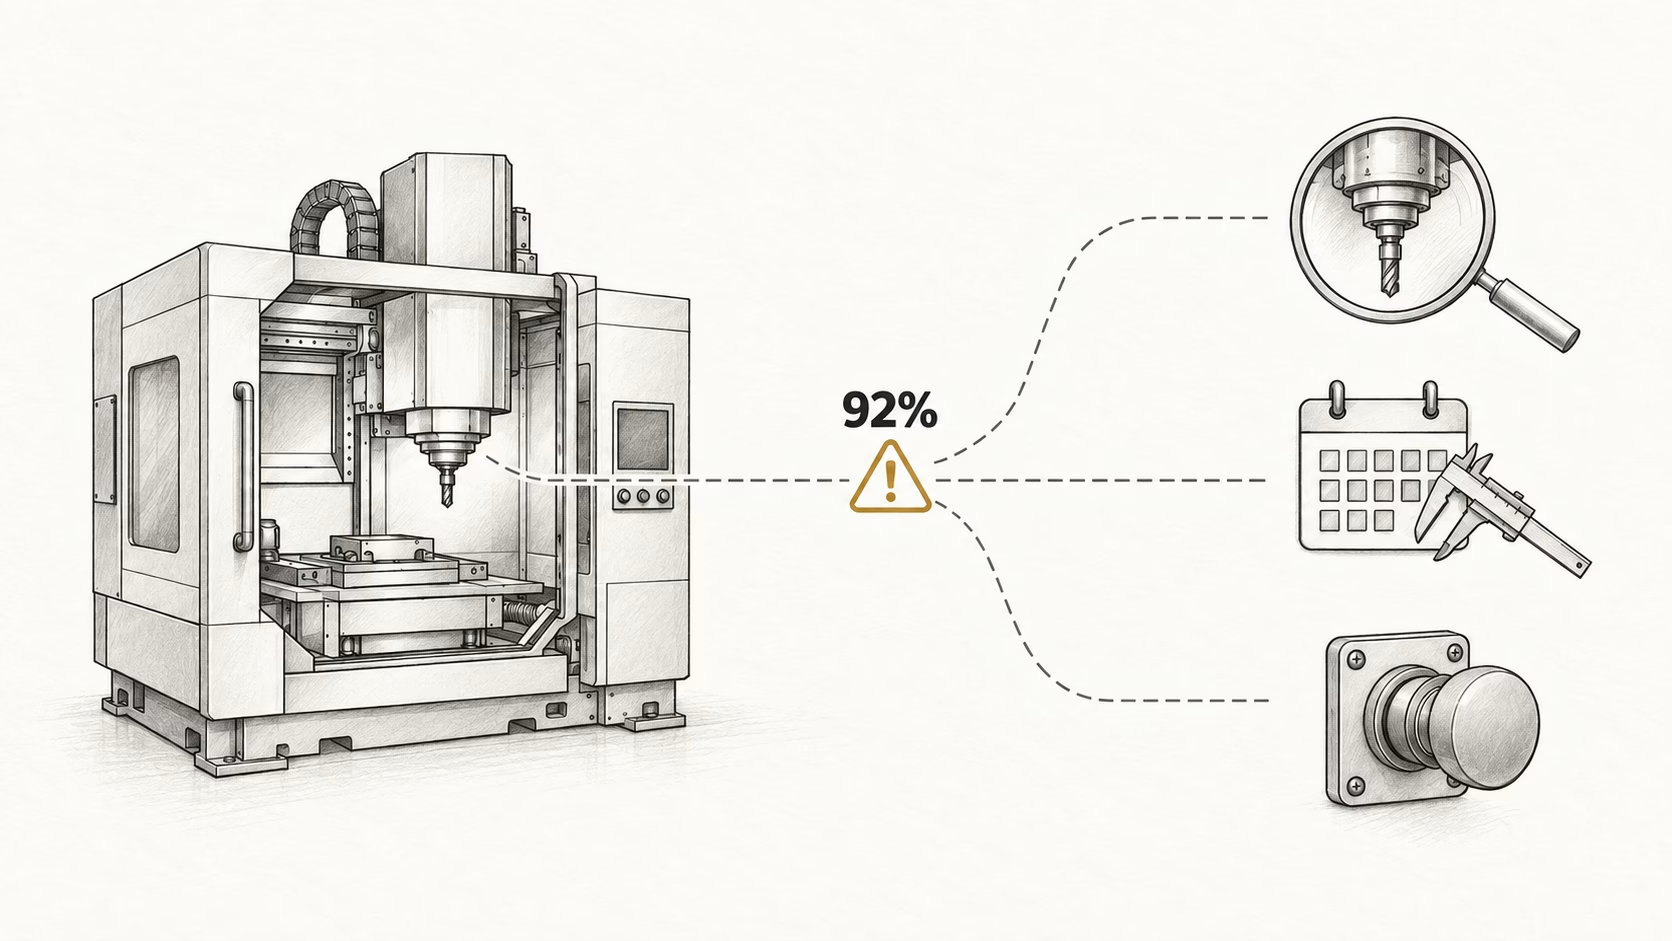
Eine Kennzahl von 92 % klingt nach einem guten Ergebnis. In einer Präsentation über ein Modell zur Erkennung drohender Maschinenstörungen könnte sie sogar wie der letzte Schritt vor der Automatisierung wirken. Doch bevor eine Anlage wegen einer Warnung anhält oder die Instandhaltung ausrückt, muss klar sein, was diese Zahl über solche Entscheidungen aussagt.
Stellen Sie sich Nordwerk vor, einen fiktiven Hersteller mit CNC-Bearbeitungszentren. Zu Beginn jeder Produktionswoche beurteilt die Instandhaltung jedes Bearbeitungszentrum: Kann es regulär weiterlaufen, sollte die Spindel zusätzlich untersucht oder eine Wartung eingeplant werden? Ein Modell soll für diesen Zeitpunkt auf Störungen hinweisen, die innerhalb der folgenden sieben Tage auftreten könnten. Würden Sie bei 92 % korrekt klassifizierten Fällen bereits einen automatischen Maschinenstopp erlauben, die Warnung als Prüfhinweis für Fachleute nutzen oder weiter testen? Merken Sie sich Ihre vorläufige Antwort. Auf sie kommen wir zurück.
Kurzfassung für Entscheider öffnen
Für Leser mit wenig Zeit: die Kernaussagen dieses Beitrags in kompakter Form.
- Kernaussage: Eine Modellmetrik ist erst im Zusammenhang mit Fehlerarten, Häufigkeit, Testbedingungen und der vorgesehenen Handlung entscheidungstauglich.
- Illustrativer Befund: Im hypothetischen Nordwerk-Beispiel verbergen 92 % Genauigkeit zugleich 78 Warnungen ohne dokumentierte Störung und zwei übersehene Störungsfälle unter 1.000 wöchentlichen Beurteilungen von Maschinen.
- Größte Unsicherheit: Selbst aussagekräftige Testmetriken zeigen noch nicht, ob ein Modell im realen Betrieb zuverlässig genug ist. Entscheidend bleiben die Übertragbarkeit der Testergebnisse, die tatsächlichen Folgen unterschiedlicher Fehler und die Wirksamkeit der anschließenden Handlungen.
- Praktische Konsequenz: Modellqualität nicht anhand einer einzelnen Kennzahl bewerten. Stattdessen Fehlerarten und ihre betrieblichen Konsequenzen gewichten, geeignete Mindestanforderungen festlegen und den tatsächlichen Prozessnutzen gegenüber dem bisherigen Vorgehen prüfen.
Was steckt in den 92 %?
Ein Entscheidungsfall ist hier genau eine wöchentliche Beurteilung eines Bearbeitungszentrums: Am Wochenanfang liegen nur die bis dahin verfügbaren Informationen vor, und die Verantwortlichen entscheiden über Weiterbetrieb, zusätzliche Untersuchung oder geplante Wartung. Für die Rechnung stellen wir uns zehn Bearbeitungszentren derselben Maschinenfamilie vor, die über rund zwei Jahre an jeweils 100 Produktionswochen beurteilt werden: 10 × 100 = 1.000 Maschinenwochen. Das ist eine rückblickende Auswertung für einen PoC; die Maschinen erhielten damals keine Hinweise dieses Modells. Dieselbe Maschine bildet in jeder Woche einen neuen Fall.
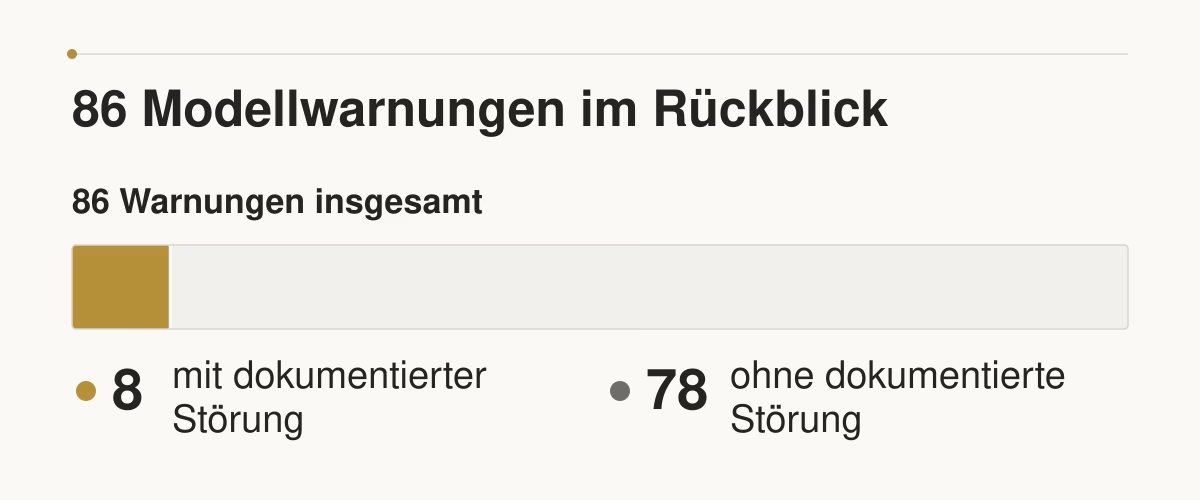
Nachträglich prüfen wir, welche Warnungen ein Modell mit den jeweils am Wochenanfang verfügbaren Daten abgegeben hätte, ohne dass seine Hinweise den damaligen Ablauf verändert haben. In zehn Fällen ist innerhalb der folgenden sieben Tage eine dokumentierte spindelbezogene Störung aufgetreten, die eine ungeplante Unterbrechung oder dringende Prüfung erforderte; in 990 Fällen nicht. Das Modell hätte acht der zehn Störungsfälle gemeldet, zwei übersehen und in 78 Fällen ohne dokumentierte Störung ebenfalls gewarnt. Sämtliche Zahlen sind erfunden und dienen ausschließlich dazu, die Entscheidungslogik sichtbar zu machen. Die zehn Störungen bilden ein kleines hypothetisches Evaluationsbeispiel. Sie sollen keine ausreichende Trainings- oder Validierungsbasis für ein reales Modell darstellen. Zahlreiche Messfenster rund um dieselben Störungen wären zudem nicht automatisch unabhängige Ereignisse.
| Tatsächlicher Verlauf | Modell warnt | Modell warnt nicht |
|---|---|---|
| Dokumentierte spindelbezogene Störung tritt ein | 8 | 2 |
| Keine solche Störung dokumentiert | 78 | 912 |
Die Genauigkeit zählt alle korrekten Zuordnungen zusammen: acht richtig erkannte Störungsfälle plus 912 berechtigte Entwarnungen ergeben 920 von 1.000 Fällen, also 92 %. Auf nur acht der 86 Warnungen folgte eine dokumentierte Störung. Die übrigen 78 Warnungen würden bei einer Prüfung Arbeit auslösen, obwohl innerhalb der sieben Tage keine solche Störung dokumentiert ist. Gleichzeitig werden zwei von zehn Störungsfällen übersehen. In der Klassifikation heißen diese Blickwinkel unter anderem Precision (Anteil der Warnungen, auf die eine dokumentierte Störung folgte: 8/86, gut 9 %) und Recall (Anteil erkannter Störungsfälle: 8/10, 80 %). Beide beantworten unterschiedliche Fragen, die in der Gesamtgenauigkeit verschwinden. [1] Welche Metriken man für welche Entscheidung braucht und wie ihre Werte zu lesen sind, vertieft ein späterer Beitrag.
Eine einfache Regel, die immer „keine Störung“ meldet, würde in genau diesem konstruierten Datensatz 990 von 1.000 Fällen richtig zuordnen: 99 % Genauigkeit, aber keine einzige Störung rechtzeitig anzeigen. Die höhere Zahl entscheidet die Frage also nicht. Ebenso wenig beweist die niedrigere Zahl, dass das Modell wertlos wäre. Wer eine Warnung tatsächlich nutzen will, muss zuerst klären, welche der Fehler für diese Handlung zählen und wie häufig sie unter den vorgesehenen Betriebsbedingungen auftreten.

Die Regel mit durchgehender Entwarnung ist eine rechnerische Referenz, nicht Nordwerks tatsächlicher Instandhaltungsprozess. Der umfasst bereits Warnungen einer Grenzwertregel, fachliche Prüfungen und Eingriffe; er bleibt für die Entscheidung über einen Pilot der betriebliche Vergleichsmaßstab. Der Beitrag „Ohne Baseline beweist selbst ein guter PoC erstaunlich wenig.“ behandelt ausführlich, warum ein einfacher Ansatz, eine bestehende Regel und der heutige Prozess unterschiedliche Fragen beantworten. Hier geht es um den nächsten Schritt: Welche Handlung lässt sich aus einem konkreten Modellergebnis verantworten?
Der gleiche Alarm, drei verschiedene Entscheidungen
Nehmen wir an, Nordwerk erwägt drei Nutzungen derselben Warnung:
- Prüfhinweis: Ein Instandhalter sieht sich die auffällige Maschine und weitere Signale an. Die Warnung ordnet Aufmerksamkeit, löst aber noch keinen Eingriff aus.
- Geplante Inspektion: Eine Warnung führt zu einem zusätzlichen Prüftermin oder zu einer vorgezogenen Wartungsentscheidung.
- Automatischer Stopp: Die Anlage hält ohne weitere fachliche Prüfung an.
Die 86 Warnungen in 100 Produktionswochen sind in allen drei Varianten dieselben: rechnerisch knapp ein Hinweis pro Woche für die zehn Maschinen. Nimmt man für die erste Sichtung beispielhaft eine halbe Stunde je Hinweis an, wären das 43 Stunden über den gesamten Zeitraum; weitergehende Untersuchungen sind dabei nicht eingerechnet. Wie sich die Warnungen auf die Wochen verteilen und wie viel zusätzlicher Prüfaufwand entsteht, verrät der Durchschnitt nicht. Schon für Variante 1 müsste Nordwerk diese Belastung im tatsächlichen Ablauf ermitteln und prüfen, ob Warnungen früh genug für eine sinnvolle Untersuchung eintreffen. In einem begrenzten Pilot müsste es außerdem beobachten, ob die Fachleute die Hinweise auch dann sorgfältig prüfen, wenn auf viele Warnungen keine dokumentierte Störung folgt. Für Variante 2 kommen Eingriffsaufwand, Produktionsplanung und die Frage hinzu, ob eine Prüfung die Störung tatsächlich besser verhindern kann. Ein automatischer Stopp verlangt darüber hinaus belastbare Grenzen für Fehlstopps und übersehene Störungen sowie ein klares Verhalten bei unsicheren Signalen.
Eine Quote korrekter Klassifikationen misst noch nicht, ob ein Einsatz wirtschaftlich ist oder im Betrieb akzeptiert wird. Auch ein richtig erkannter Fall nützt wenig, wenn die Warnung zu spät kommt, die vermeintliche Störung nicht beeinflussbar ist oder der passende Eingriff fehlt. Die Bewertung muss deshalb zum beabsichtigten Einsatz und zu realistischen Testbedingungen passen; dabei sind auch die unterschiedlichen Folgen von Fehlern zu berücksichtigen. [2] Wie sich der technische Effekt über rechtzeitige und wirksame Handlungen in zusätzlichen wirtschaftlichen Nutzen übersetzen lässt, vertieft der Beitrag „Wenn der Business Case an einer Zahl kippt, die im PoC gar nicht gemessen wird“.
Für das Nordwerk-Beispiel würde ich aus 92 % allein keinen automatischen Stopp ableiten. Eine begrenzte Prüfung als Hinweis für Fachleute könnte dagegen eine sinnvolle nächste Teststufe sein, sofern Kapazität, Vorwarnzeit und die Qualität der Warnungen unter realistischen Bedingungen überprüft werden. Wie sich aus Prüfhinweis, betrieblichem Eingriff oder automatischer Reaktion jeweils unterschiedliche zeitliche Anforderungen ergeben, zeigt „Brauchen Sie wirklich Echtzeitdaten?“. Auch das ist noch keine Produktivfreigabe. Welche Governance-Kontrollen je nach tatsächlicher Nutzung hinzukommen, vertieft „Wann wird aus einer guten KI-Idee ein Governance-Thema?“.
Warum die „beste“ Metrik erst aus der Aufgabe folgt
Der Fehler beginnt oft früher als bei der Auswertung. Wer am Projektstart „möglichst hohe Genauigkeit“ als Anforderung formuliert, legt damit noch nicht fest, welche Entscheidung besser werden soll. Das Modell kann die gewählte Zahl verbessern, während eine seltene, aber folgenreiche Störung weiter übersehen wird. Umgekehrt kann ein Ansatz mehr Störungen entdecken und dabei so viele Hinweise produzieren, dass sie im Alltag nicht zuverlässig geprüft werden.
Die Reihenfolge sollte deshalb von der vorgesehenen Handlung ausgehen:
- Entscheidungsfall: Welche Maschine wird zu welchem Zeitpunkt für welchen Zeitraum beurteilt?
- Handlung: Was passiert bei Warnung und Entwarnung, und wer trifft die letzte Entscheidung?
- Fehlerfolgen: Was richtet eine übersehene Störung an? Was bewirkt ein unnötiger Alarm? Welche Fälle dürfen keinesfalls automatisch entschieden werden?
- Mindestanforderungen: Welche Leistung braucht der Prozess unter seinen realen Ressourcen und Grenzen?
- Messung: Welche absoluten Fallzahlen und Kennzahlen zeigen, ob diese Anforderungen eingehalten werden?
Bei einem Klassifikationsmodell beeinflusst der Entscheidungsschwellenwert, ab welchem Modellwert ein Alarm entsteht. Ein anderer Schwellenwert verändert typischerweise das Verhältnis zwischen erkannten Fällen und Fehlalarmen. Er wird deshalb anhand der konkreten Anwendung gewählt und auf dafür geeigneten Daten geprüft. Modellwert und daraus abgeleitete Handlung sind unterschiedliche Entscheidungen; eine allgemeingültige „gute“ Prozentzahl folgt daraus nicht. [3]
Wie stark ungeprüfte Annahmen über Reaktionsmöglichkeiten, Prüfaufwand und vermeidbare Schäden einen Business Case verändern können, vertieft der Beitrag „Wenn der Business Case an einer Zahl kippt, die im PoC gar nicht gemessen wird“. Hier ist zunächst entscheidend: Was würden übersehene Störungen und Warnungen ohne dokumentierte Störung im vorgesehenen Arbeitsablauf auslösen, und wäre das für Nordwerk tragbar?
Was ich aus einem anderen ML-Projekt mitgenommen habe
In einem Machine-Learning-Projekt, in dem wir mögliche Fehlerursachen in großen Fehlerdaten mithilfe eines Clusteralgorithmus gruppieren wollten, habe ich eine wichtige Lektion gelernt: Eine früh begonnene Diskussion über Modellmetriken kann Anforderungen in die falsche Richtung lenken. Bei uns rückte die Verbesserung einer Modellzahl in den Vordergrund, bevor ausreichend klar war, wie die Gruppierungen im Arbeitsablauf genutzt und wie mit tatsächlich auftretenden Fehlern umgegangen werden sollte.
Erst mit der genaueren Klärung des Betriebsprozesses und dem Umgang mit den tatsächlich auftretenden Fehlern ließ sich sinnvoll einordnen, welche Ergebnisse überhaupt brauchbar waren. Später wurden Metriken wichtig für die Deltabetrachtung: Wir konnten Veränderungen zwischen Varianten beurteilen, weil das fachlich akzeptable Niveau, die Anforderungen der Nutzer und die Mindestleistung für einen tragfähigen Business Case bereits konkreter waren.
Zurück zum fiktiven Nordwerk-Beispiel: Dort geht es um eine binäre Warnentscheidung und damit um andere Kennzahlen als bei der Gruppierung von Fehlerursachen. Die praktische Erfahrung ist dennoch übertragbar: Erst wenn feststeht, was das Ergebnis im Prozess leisten soll, lässt sich eine Verbesserung der Modellmetrik als Fortschritt für die Nutzer bewerten.
Ein Ergebnis ist nur so belastbar wie sein Test
Selbst eine passende Fehlermatrix kann Nordwerk zu sicher machen. Entscheidend ist, wie die Fälle entstanden sind. Wurden die Messwerte vor dem Zeitpunkt erhoben, zu dem eine Warnung nötig gewesen wäre? Enthält der Test andere Maschinen, Betriebszustände und Zeiträume als die spätere Anwendung? Wurde ein Grenzwert mehrfach an denselben Testfällen angepasst? Zählen viele nahezu gleiche Messfenster um eine einzige Störung fälschlich wie unabhängige Erfolge?
Solche Fragen ändern die Bedeutung einer Kennzahl. Werden Informationen verwendet, die zum Warnzeitpunkt noch nicht verfügbar waren, kann der Test eine zu günstige Leistung zeigen. [4] Bei zeitlich geordneten Daten muss auch die Aufteilung in Trainings- und Testfälle dazu passen, dass eine spätere Anwendung nur auf früheren Informationen aufbaut. [5] Welche Trennung Nordwerk konkret braucht, hängt von Maschinen, Ereignissen und dem späteren Einsatz ab. Die wöchentlichen Fälle können zudem mehrfach von derselben Maschine stammen und sind dann nicht automatisch unabhängige Beobachtungen. Außerdem kann eine frühere Wartung eine Störung verhindert haben: Eine Warnung ohne nachfolgend dokumentierte Störung wäre dann nicht zwingend ein unnötiger Hinweis. Die illustrative Tabelle mit nur zehn Störungsfällen liefert ohnehin keinen Beleg dafür, dass die Kennzahlen stabil auf andere Zeiträume oder Anlagen übertragbar sind.
Für eine Entscheidung sollte der Test deshalb nicht bei einer aggregierten Prozentzahl enden. Nordwerk müsste mindestens die absoluten Fehlerzahlen, die Alarme je bearbeitbarer Zeiteinheit, die rechtzeitigen Warnungen, den heutigen Ablauf als Vergleich und die Leistung unter unterschiedlichen Betriebsbedingungen gemeinsam betrachten. Wenn das Modell einen Eingriff auslöst, gehört dessen Wirkung ebenfalls in die spätere Prüfung. Ein Modelltest und ein belastbarer Nachweis für den Nutzen des gesamten Arbeitsprozesses sind unterschiedliche Stufen.
Zurück zur Entscheidung bei Nordwerk
Am Anfang standen drei Möglichkeiten: sofortiger Maschinenstopp, fachlich geprüfter Hinweis oder weiterer Test. Nach den hypothetischen Zahlen ist der automatische Stopp nicht freigabefähig. Aus 78 Warnungen ohne dokumentierte Störung, zwei übersehenen Störungsfällen und einem noch nicht im Alltag geprüften Eingriff lässt sich seine Verhältnismäßigkeit nicht bestimmen.
Ein begrenzt eingesetzter Prüfhinweis ist die plausibelste nächste Lernstufe, falls Nordwerk die Warnungen im tatsächlich anfallenden Wochenvolumen sorgfältig bearbeiten kann und sie rechtzeitig eintreffen. Eine geplante Inspektion kann aus einer fachlichen Prüfung folgen; als feste Reaktion auf jede Modellwarnung wäre sie mit diesen Daten noch nicht begründet. Kann Nordwerk die Hinweise nicht sorgfältig und rechtzeitig bearbeiten, muss auch diese Teststufe verändert oder zurückgestellt werden. Vor einer späteren Freigabe wären der passende Vergleich zum heutigen Vorgehen, eine realistische Prüfung der Fehlertypen und die Beobachtung des tatsächlichen Arbeitsablaufs nötig. Ob ein weiterer begrenzter Versuch den Aufwand rechtfertigt oder das Vorhaben beendet werden sollte, vertiefe ich im Beitrag Wann ist Nicht-Weiterführen das beste Ergebnis eines KI-Projekts?
Zusammenfassung
- Die Einheit der Messung zählt: Bei Nordwerk ist ein Fall die wöchentliche Beurteilung einer Maschine mit einem festgelegten Warnhorizont von sieben Tagen. Ohne diesen Bezug lässt sich die Zahl 92 % kaum interpretieren.
- Die Fehlerbilanz zählt: 92 % Genauigkeit bedeuten im Beispiel acht erkannte und zwei übersehene Störungsfälle sowie 78 Warnungen ohne dokumentierte Störung. Dieselbe Bilanz kann für einen menschlich geprüften Hinweis und für einen automatischen Stopp völlig unterschiedliche Folgen haben.
- Der Testkontext zählt: Ein Warnwert muss rechtzeitig vorliegen, an realistischen Fällen geprüft sein und sich im vorgesehenen Ablauf bearbeiten lassen. Das Ergebnis des Modells belegt noch nicht die Wirkung einer Wartungsentscheidung.
Wann ist eine Modellmetrik für eine reale Automatisierungsentscheidung ausreichend? Wenn sie auf passend definierten und realistisch geprüften Fällen beruht, die entscheidenden Fehler und ihre Häufigkeit offenlegt und zusammen mit den Folgen der vorgesehenen Handlung zeigt, dass deren Mindestanforderungen erreicht werden. 92 % allein erfüllen diese Bedingung nicht.
Einseitige Zusammenfassung herunterladen (PDF · 1 Seite)
Quellen
- Google, Classification: Accuracy, recall, precision, and related metrics – Definitionen und Grenzen der Metriken bei ungleichen Klassenhäufigkeiten.
- NIST, AI Risks and Trustworthiness, Abschnitt 3.1 – Einsatzkontext, realistische Testfälle und Fehlerfolgen.
- scikit-learn, Tuning the decision threshold for class prediction – Modellwert, Schwellenwert und Entscheidungsregel.
- scikit-learn, Common pitfalls and recommended practices, Abschnitt 12.2 – Datenleckage und zu optimistische Leistungsschätzungen.
- scikit-learn, TimeSeriesSplit – zeitlich geordnete Trainings- und Testdaten.
Fachlich passende Artikel
Fachlich ergänzt am 4. Oktober 2026: Die zehn Störungen ausdrücklich als kleines hypothetisches Evaluationsbeispiel eingeordnet.
Weiter im Facharchiv
Zur Kategorie „Qualität & Bewertung“ · Alle Fachbeiträge · Fachlicher Lernpfad: Von der KI-Idee zur Projektentscheidung · Alle Themenbereiche