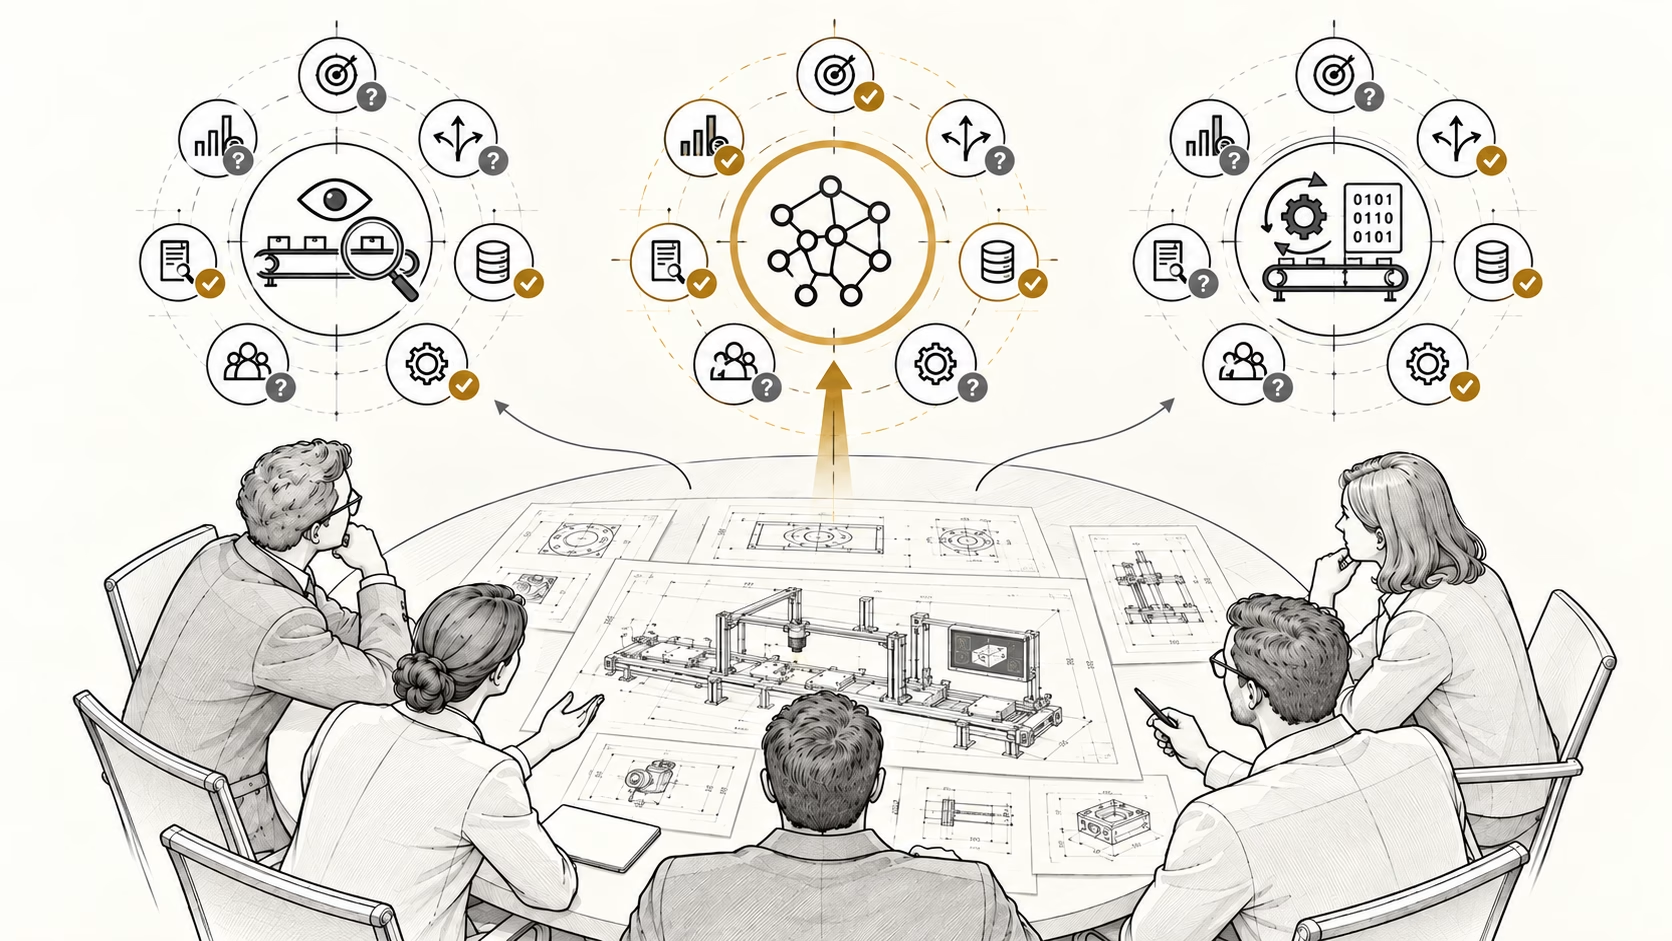
Fachwissen allein schützt ein Team nicht vor einer verzerrten KI-Entscheidung. Drei Gespräche bei einem fiktiven Automobilzulieferer zeigen, wie bestätigende Befunde, frühe Schätzungen und scheinbare Einigkeit die gemeinsame Bewertung verengen können – und wie Teams dagegen vorgehen.
Wir begleiten Steinbach Metalltechnik, einen fiktiven Automobilzulieferer mit rund 250 Mitarbeitenden. Die Sichtprüfung der betrachteten Bauteiloberflächen erfolgt dort bislang überwiegend manuell. Geschultes Prüfpersonal beurteilt sichtbare Abweichungen anhand festgelegter Kriterien; auffällige oder strittige Teile werden genauer untersucht, bevor über Freigabe, Nacharbeit oder Ausschuss entschieden wird. Nun zeigt ein Anbieter eine kamerabasierte Assistenz: Unter definierter Beleuchtung aufgenommene Bilder werden von einem neuronalen Netz ausgewertet, das verdächtige Stellen für das Prüfpersonal markiert. Prüfablauf und Gesprächsszenen sind für diesen Fall konstruiert.
In der auf die Anbieterpräsentation folgenden, internen Besprechung kennt die Produktion den Prüfablauf, die Qualität die Fehlerfolgen und das Controlling die wirtschaftlichen Anforderungen. Trotzdem spricht die Runde bereits über die Einführung einer KI-Lösung, obwohl Nutzen und Alternativen größtenteils noch ungeklärt sind. Wie kann ein fachkundiges Team gemeinsam zu einer Empfehlung gelangen, die seine Wissensgrundlage nicht trägt?
Die Produktionsleitung erhofft sich Entlastung. Welche manuellen Prüfschritte tatsächlich entfallen könnten, ist jedoch ebenso offen wie der Vergleich mit einer verbesserten manuellen Prüfung oder regelbasierter Bildverarbeitung. Die Runde wertet die überzeugende Vorführung dennoch bereits als Argument für die weitere Projektplanung. Als eine Prüferin nach seltenen Bauteilvarianten fragt, wird die Untersuchung auf später verschoben, ohne einen verbindlichen Prüfauftrag festzuhalten.
Welches Muster sollte das Team anhand dieser Beobachtung zuerst gegenprüfen?
- A – Unterschiedliche Belegmaßstäbe: Für die positive Einschätzung genügt die Vorführung, während ein möglicher Gegenbefund erst nach genauer Untersuchung Gewicht erhalten soll.
- B – Orientierung an einer frühen Schätzung: Die Beteiligten übernehmen einen ersten Zahlenwert als Ausgangspunkt und korrigieren ihn, statt unabhängig zu rechnen.
- C – Unvollständiger Wissensaustausch: Die Runde stützt sich auf gemeinsam bekannte Informationen, während besondere Erfahrungen einzelner Beteiligter nicht eingebracht werden.
Im weiteren Verlauf prüfen wir, wie daraus eine verzerrte Teamentscheidung entstehen könnte und woran sich eine berechtigte Empfehlung davon unterscheiden ließe.
Kurzfassung für Entscheider öffnen
Für Leser mit wenig Zeit: die Kernaussagen dieses Beitrags in kompakter Form.
Kernaussage: Bei einem KI-Vorhaben können beispielsweise eine überzeugende Anbieterdemo und ungeprüfte Nutzenannahmen vorschnell zur gemeinsamen Entscheidungsgrundlage werden. Fachwissen hilft dem Projektteam nur, wenn Grenzen der KI-Lösung und Erfahrungen aus dem realen Betriebsprozess konsequent auf Basis unvoreingenommener Annahmen gegenprüft werden.
Evidenz: Forschung dokumentiert Bestätigungsfehler, Ankereffekte und Verzerrungen beim Informationsaustausch. Die systematische Prüfung dieser Mechanismen hilft, mögliche Fehlentwicklungen im betroffenen Projekt zu erkennen.
Zentrale Unsicherheit: Die größte Unsicherheit liegt darin, ob die gemeinsame Bewertung auf einer ausgewogenen Prüfung beruht: Wurden widersprechende Befunde, alternative Erklärungen und abweichende Einschätzungen tatsächlich berücksichtigt, oder hat eine frühe gemeinsame Überzeugung die Auswahl und Gewichtung der Informationen verzerrt?
Konsequenz: Vor einer Freigabe die tragenden Annahmen und Gegenargumente ausdrücklich dokumentieren: Welche Ergebnisse sprechen gegen die bevorzugte KI-Lösung, wie schneidet sie gegenüber realistischen Alternativen ab und welche Beobachtung würde die Empfehlung ändern? Relevante Gegenbefunde müssen in die Bewertung einfließen, bevor über den nächsten Schritt entschieden wird.
Wie sich das Urteil im Team verengt
Mehrere Fachperspektiven können dieselbe ungeprüfte Voraussetzung übernehmen, etwa wenn Produktion und Projektleitung auf dieselben Demo-Beispiele vertrauen und das Controlling deren Nutzenannahmen verwendet. Die Empfehlung wirkt dann breiter abgesichert, als ihre Grundlage trägt.
Bei diesem KI-Vorhaben ergänzen sich unterschiedliche Kenntnisse: Die Qualität beurteilt Fehlerfolgen, der Anbieter die Technik und die Produktion den Prüfablauf. Das Controlling rechnet mit den zugearbeiteten Annahmen. Die Runde muss gemeinsam klären, ob ihre Einschätzungen zusammenpassen und was ein technischer Erfolg im Arbeitsablauf bedeuten würde.
Systematisch bedeutet hier eine gerichtete Tendenz bei der Auswahl und Gewichtung von Informationen. Umgekehrt könnte eine skeptischere Runde Vorteile einer KI-Lösung besonders streng und Nachteile weniger streng prüfen. Maßgeblich ist, wie die Beteiligten ihre Empfehlung begründen und Gegenbefunde prüfen.
Wir bleiben in der frühen Projektphase und verfolgen drei Gespräche: die Einordnung der Vorführung, die erste Nutzenplanung und die Vorbereitung einer Budgetfreigabe für einen begrenzten Versuch. Die folgenden Situationen veranschaulichen drei mögliche Mechanismen, die die gemeinsame Wahrnehmung und Bewertung verengen können. Darüber hinaus gibt es weitere Ursachen, die im anschließenden Überblick und den Detailartikeln des fachlichen Lernpfads behandelt werden. Die Szenen illustrieren mögliche Verzerrungen, ohne einzelne Personen zu diagnostizieren.
| Gesprächsmoment | Was geklärt werden soll | Wie sich die Bewertung verengen kann |
|---|---|---|
| Präsentation der Lösung durch Implementierer einordnen | Passt die angebotene Lösung zu unserem Problem? | Positive Befunde dominieren, Einwände werden ohne saubere Evidenz abgetan oder vertagt (Confirmation Bias). |
| Nutzen abschätzen | Welche Arbeit entfällt und welche kommt hinzu? | Eine frühe Einschätzung, etwa durch den Anbieter, wird nur noch in kleinem Rahmen korrigiert, anstatt davon losgelöst zu bewerten (Anchoring Bias). |
| Budgetempfehlung vorbereiten | Reicht das zusammengetragene Wissen? | Gemeinsam Bekanntes verdrängt besondere Beobachtungen Einzelner (einseitiger Informationsaustausch). |
1. Wenn die Runde bestätigende Befunde weiterverfolgt
Bei der eingangs beschriebenen Vorführung präsentiert der Anbieter zusammengefasste Kennzahlen, die die Projektleitung als Machbarkeitssignal wertet. Der vertagte Einwand betrifft seltener vorkommende Bauteilvarianten mit weniger auffälligen Oberflächenabweichungen. Offen bleibt, welche Bedeutung sie für den vorgesehenen Einsatz haben, in welchem Umfang sie untersucht werden müssen und wer dies bis spätestens zu welchem Folgeschritt klärt.
Der mögliche Bestätigungsfehler liegt darin, dass positive Kennzahlen bereits als Begründung für den nächsten Projektschritt genügen, während mögliche Gegenbefunde erst nach einer detaillierten Untersuchung Gewicht erhalten sollen. Der Einwand wird zwar aufgenommen, seine Klärung bleibt aber ohne erkennbare Konsequenz für die vorläufige Empfehlung. Wenn die Runde bestätigende Informationen regelmäßig leichter akzeptiert als widersprechende, verengt sie ihre gemeinsame Bewertungsgrundlage.
Eine solche Informationsbewertung passt zum Bestätigungsfehler, auch Confirmation Bias genannt: Informationen werden bevorzugt so gesucht oder gewichtet, dass sie eine bestehende Einschätzung stützen. Auch in der Softwareprüfung ist die Neigung untersucht, erwartetes Funktionieren zu bestätigen und zu wenig nach Gegenfällen zu suchen.[1] Im Team muss deshalb sichtbar werden, welche Befunde für Zustimmung genügen und welche Belege von skeptischen Stimmen verlangt werden.
Eine Variante auf später zu verschieben kann durchaus angemessen sein, wenn sie außerhalb des vereinbarten Einsatzbereichs liegt. Im Gespräch müsste die Runde diese Grenze dann ausdrücklich festhalten und ihre Empfehlung darauf beschränken. Ungeklärt zu vertagen und trotzdem eine breite Eignung anzunehmen, wäre dagegen eine schlechtere Schlussfolgerung.
Bilderkennung hängt von Prüfaufgabe und Bildgewinnung ab.[2] Die Untersuchung am AutoVI-Bilddatensatz aus der Automobilproduktion zeigt, wie reale Aufnahmebedingungen die visuelle Anomalieerkennung erschweren können.[3] Für sichtbare Oberflächenabweichungen brauchen Qualität, Produktion und Prüfpersonal deshalb einen gemeinsamen Fehlerkatalog und unabhängige Referenzbewertungen. An denselben Teilen lassen sich etwa Reflexionen, Beleuchtungsänderungen und verschmutzte Optiken untersuchen. Eine Markierung entscheidet noch nicht über Ausschuss oder Freigabe.
Die Gegenmaßnahme beginnt daher vor der nächsten Vorführung: Die Runde hält gemeinsam fest, welche bislang fehlenden Fälle geprüft werden und welcher Befund gegen den vorgesehenen Einsatz sprechen würde. Das gezielte Durchdenken einer Gegenposition kann Urteilsverzerrungen vermindern.[4] Für unseren Fall wird daraus ein konkreter Prüfauftrag, dessen Ergebnis auch die Empfehlung verändern darf. Die gezielte Prüfung seltener Bauteilvarianten und unauffälliger Abweichungen kann Schwächen des Modells aufdecken. Wie häufig die KI im laufenden Betrieb Fehler übersehen oder zulässige Teile fälschlich markieren würde, lässt sich daraus noch nicht ableiten. Dafür braucht es zusätzlich Prüfteile, die den späteren Produktionsmix einschließlich der üblichen zulässigen Teile angemessen abbilden.
Wie die Haltung zur KI die Zusammenarbeit prägt
In einem ähnlichen, qualitätsnahen Machine-Learning-Projekt habe ich erlebt, wie stark unterschiedliche Einstellungen zur KI die Arbeitsrichtung beeinflussten. Starke Befürworter neigten dazu, Nachteile kleinzureden und auf Kompetenzaufbau oder mögliche Transfereffekte zu verweisen. Bei skeptischen Beteiligten brauchte es dagegen viel Überzeugungsarbeit für die nächsten Prüfschritte. Nach meiner Beobachtung betrafen ihre Vorbehalte sowohl das Ergebnis als auch die Folgen für die eigene Arbeit.
Eine der Lektionen aus diesem Projekt war, Zielerreichung, zusätzlichen Lernnutzen und Veränderungen der Arbeit aller Beteiligten sowohl im Gesamtprojekt als auch in der teaminternen Kommunikation getrennt zu behandeln. Andernfalls können die Bewertungen dieser unterschiedlichen Ziele ineinanderfließen und Entscheidungen verzerren. Kompetenzaufbau kann auch im genannten Beispielfall erwünscht sein, ersetzt hier aber keine Belege für die Entlastung der Sichtprüfung. Ebenso verdienen Sorgen um die eigene Arbeit konkrete Antworten. Weder Begeisterung noch Skepsis legt dauerhaft fest, wie jemand urteilt, und beide können fachlich berechtigte Gründe enthalten.
2. Wenn die erste Zahl zum gemeinsamen Maßstab wird
Nach der Vorführung legt der externe Anbieter eine erste Schätzung der jährlichen Entlastung durch die KI-Lösung vor. Das Controlling fordert einen Sicherheitsabschlag, die Produktion hält eine etwas geringere Einsparung für erreichbar. Obwohl beide Seiten vorsichtig argumentieren, korrigieren sie denselben Ausgangswert, ohne dessen Herleitung zunächst im Detail geprüft zu haben.
Die Orientierung an einem zuvor betrachteten Zahlenwert wird als Anchoring oder Ankereffekt beschrieben. Auch fachkundige Schätzungen können davon betroffen sein.[5] Eine erste Einschätzung durch externe Anbieter kann sachlich sinnvoll sein, und ihre Korrektur kann zusätzliche Informationen enthalten. Problematisch wird es aber dann, wenn die Runde diese Annäherung als unabhängige Bestätigung der angebotenen Lösung wertet, obwohl die tragenden Annahmen der Herleitung nicht mindestens durch die prozess- und betriebskundigen internen Stellen eigenständig geprüft wurden.
Für die erste Einsparschätzung ist der tatsächliche Prüfablauf deshalb so wichtig, weil er bestimmt, welche Arbeit ein KI-Hinweis auslöst. Muss jedes markierte Teil ausgeschleust und separat untersucht werden? Gibt es dafür innerhalb des Produktionstakts ausreichend Kapazität? Werden unmarkierte Teile weiterhin manuell geprüft? Erst diese Festlegungen zeigen, welchen Aufwand Fehlalarme verursachen und welche bisherigen Tätigkeiten überhaupt entfallen könnten. Neben der verfügbaren Kapazität gehören auch die Kosten der Prüfungen und die möglichen Folgen übersehener Fehler in die Rechnung, etwa Nacharbeit, Ausschuss oder Reklamationen. Eine automatische Freigabe wäre eine weitergehende Aufgabe mit eigenem Prüfbedarf.
Welche Kennzahlen die Runde auseinanderhalten muss
Um die Einsparschätzung unabhängig zu prüfen, muss die Runde die zusammengefassten Demo-Kennzahlen in erkannte Fehler, übersehene Teile und zusätzliche Nachprüfungen übersetzen. Im folgenden Visual wird dafür jedes Bauteil anhand einer unabhängigen Referenz als zulässig oder nichtkonform und durch die KI als markiert oder unmarkiert eingeordnet. Daraus entstehen richtig erkannte Fehlerteile (True Positive, TP), übersehene Fehlerteile (False Negative, FN), Fehlalarme (False Positive, FP) und richtig unmarkierte zulässige Teile (True Negative, TN). Die Kennzahlen beziehen sich auf unterschiedliche Gruppen:[6]
- Sensitivität (Recall): Anteil erkannter Teile an allen tatsächlich nichtkonformen Teilen.
- Fehlalarmrate: Anteil fälschlich markierter Teile an allen zulässigen Teilen.
- Spezifität: Anteil richtig unmarkierter Teile an allen zulässigen Teilen, ergänzt die Fehlalarmrate zu 100 Prozent.
- Precision: Anteil tatsächlich nichtkonformer Teile an allen markierten Teilen.
- Accuracy (Gesamtgenauigkeit): Anteil aller richtig eingestuften Teile, also TP und TN, an sämtlichen Prüfteilen.
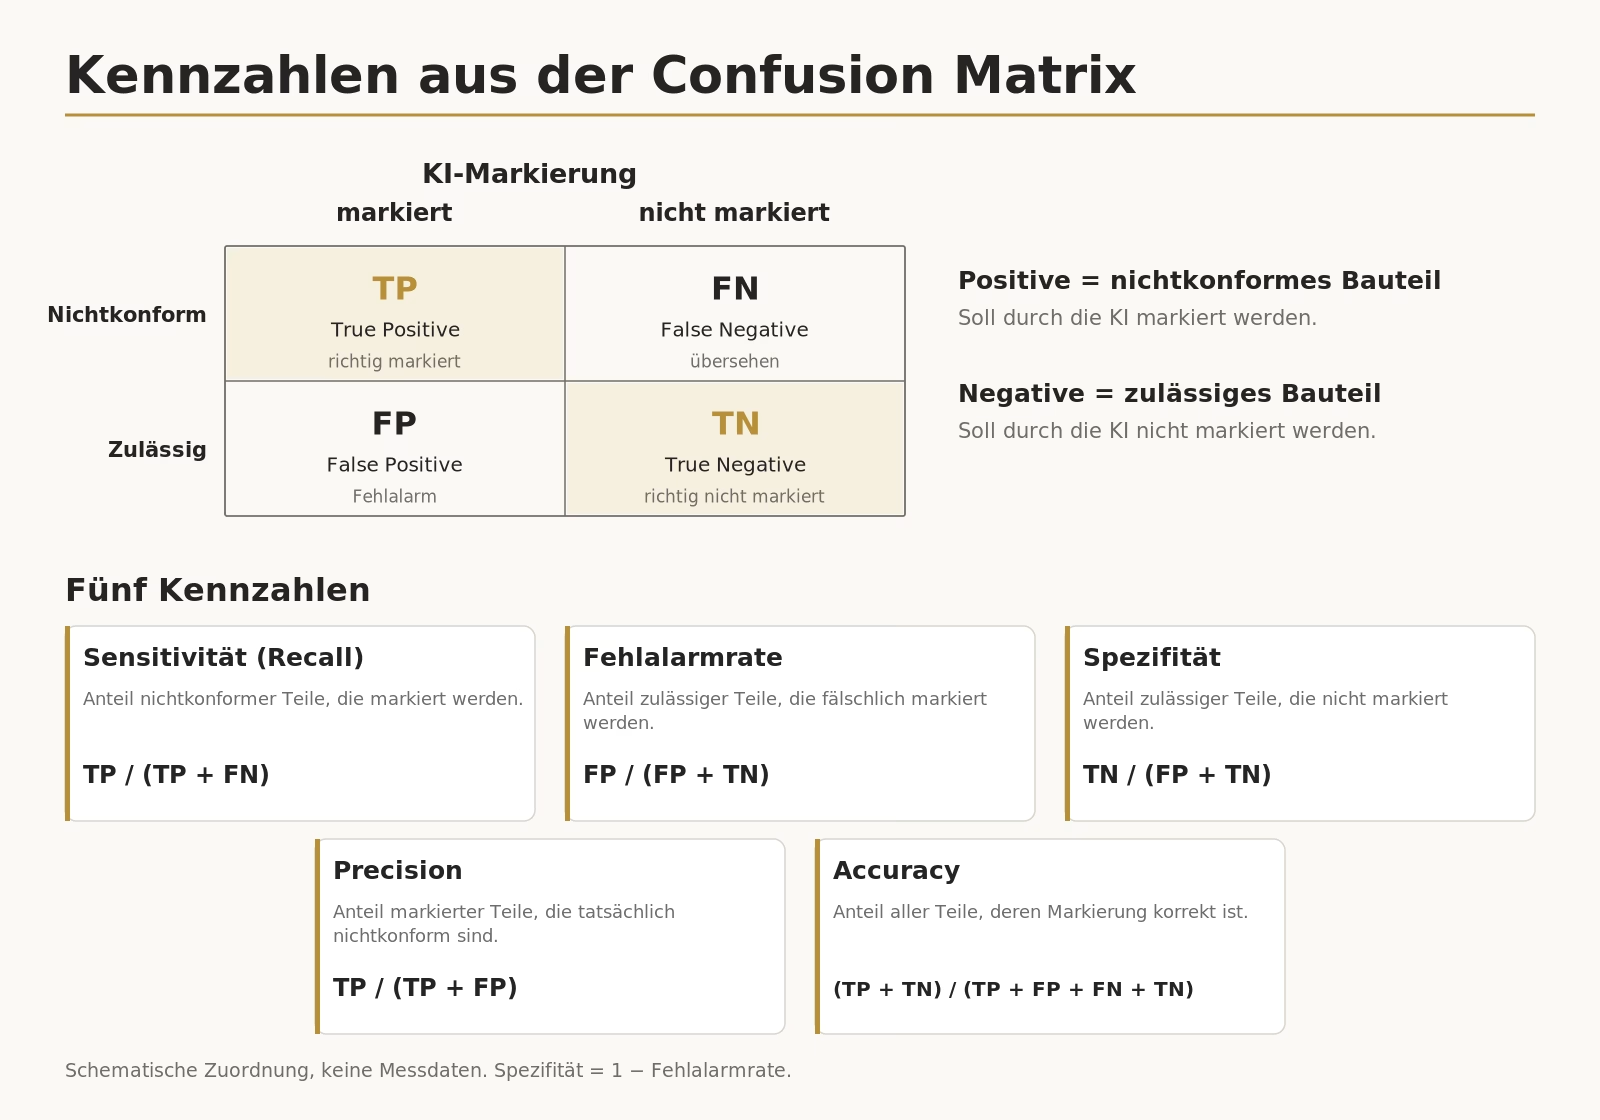
Für Steinbach bedeutet eine hohe Sensitivität zunächst, dass viele tatsächlich nichtkonforme Teile erkannt werden. Ob dadurch manuelle Arbeit entfällt, bleibt eine Frage des Prüfablaufs. Fehlalarmrate und Spezifität beschreiben den Umgang mit zulässigen Teilen, während die Precision erkennen lässt, wie häufig eine Markierung tatsächlich einen Fehler betrifft. Viele unbegründete Markierungen könnten die verfügbare Nachprüfkapazität beanspruchen. Eine hohe Accuracy allein beantwortet deshalb weder die Frage nach der beherrschbaren Fehlerbelastung noch nach der wirtschaftlichen Entlastung. Wie solche Kennzahlen zusammen mit Fehlerfolgen zu bewerten sind, vertieft „92 % Genauigkeit: Würden Sie damit einen Prozess automatisieren?“ Eine weiterführende Einordnung von Klassenhäufigkeiten und Entscheidungsschwellen folgt im Beitrag zu geeigneten Modellmetriken (Artikel ausstehend).
Controlling und Produktion sollten deshalb zunächst eigenständig aus Prüfmenge, Prüfzeit, Nachprüfung und real veränderbarer Kapazität rechnen. Qualität klärt Fehlerfolgen, Projektleitung und Anbieter ergänzen Aufnahmeaufbau, Datenkennzeichnung, Integration und Betrieb. Ist die frühe Schätzung bereits bekannt, hilft die gezielte Suche nach Gründen, weshalb sie zu hoch oder zu niedrig sein könnte, ihren Ankereinfluss zu verringern.[5] Anschließend werden gegebenenfalls unterschiedliche Annahmen verglichen, statt lediglich einen Mittelwert zu bilden. Wie aus veränderter Arbeit ein wirtschaftlicher Nutzen entstehen kann, behandelt die Vertiefung zum Business Case nach dem PoC. Welche unsicheren Nutzen- und Kostenannahmen das Ergebnis besonders verändern, wird im Beitrag zur Sensitivitätsanalyse vertieft (Artikel ausstehend).
Ebenso muss die Gegenrechnung auch eine verbesserte manuelle Prüfung und regelbasierte Bildverarbeitung einbeziehen. Auch für diese Alternativen sind Fehlererkennung und Nachprüfaufwand an vergleichbaren Prüfteilen unter vergleichbaren Einsatzbedingungen zu untersuchen. Für alle Optionen gelten dieselben Anforderungen und Belegmaßstäbe, der heutige Ablauf bildet die betriebliche Baseline.
3. Wenn Einigkeit das fehlende Wissen verdeckt
Vor der Budgetfreigabe für einen begrenzten Versuch fragt die Geschäftsführung nach grundsätzlichen Bedenken. Die Runde wiederholt Demo-Ergebnisse und Schätzungen und wertet deren Übereinstimmung bereits als Absicherung der Empfehlung. Die Einschätzungen und spezifischen Erfahrungen des Prüfpersonals aus dem laufenden Betrieb wurden bislang noch nicht systematisch in die Betrachtung einbezogen.
Gemeinsam bekannte Informationen können eine Diskussion stärker prägen, während besonderes Wissen Einzelner unzureichend zusammengeführt wird.[7] Der mögliche Mechanismus in unserer Szene liegt darin, dass die Wiederholung bekannter Befunde Sicherheit erzeugt, bevor die Runde ergänzende oder widersprechende Beobachtungen einholt.
Die Projektleitung fragt daraufhin gezielt nach bislang unbesprochenen Beobachtungen. Eine Prüferin berichtet, dass bestimmte Grenzfälle bei der Übergabe an die Spätschicht wiederholt neu diskutiert werden. Nun müsste geklärt werden, ob Kriterien uneinheitlich angewendet werden, sich der Produktmix ändert oder andere, gegebenenfalls schichtbezogene Prüfbedingungen vorliegen. Auch die Weitergabe strittiger Fälle und Änderungen am Fehlerkatalog gehört zur Untersuchung. Prüfmüdigkeit ist eine mögliche Erklärung, folgt aber nicht aus dem Schichtwechsel allein.
Eine Untersuchung zur Sichtprüfung lackierter Fahrzeugkarosserien zeigt, dass eine angepasste Beleuchtungs- und Kontrastgestaltung die Fehlererkennung verbessern und die Augenbelastung verringern kann.[8] Eine Felduntersuchung zur Gepäckprüfung beobachtete bei hoher Bildrate einen Leistungsrückgang mit zunehmender Prüfdauer.[9] Steinbach sollte deshalb Beleuchtung, Prüftempo und Prüfdauer gemeinsam erfassen. Für die Teamentscheidung hat die bislang nicht geteilte Beobachtung eine konkrete Folge: Werden gleiche Grenzfälle unterschiedlich bewertet, fehlt eine verlässliche Referenz, um KI, manuelle Prüfung und regelbasierte Bildverarbeitung fair zu vergleichen.
Als Gegenmaßnahme hält jede Funktion zunächst für sich Beobachtungen, Annahmen und offene Fragen fest. Erst nachdem dieses Wissen zusammengetragen wurde, bewertet die Runde die Optionen. Qualität und Produktion können ausgewählte Teile wiederholt bewerten lassen, um unterschiedliche Grenzfallurteile zu klären und eine Referenz für den Vergleich der Verfahren aufzubauen.
Für die Besprechung würde das bedeuten, zuerst nach Beobachtungen und ihren Folgen zu fragen, bevor jede Funktion ihre Empfehlung ausspricht. So lässt sich unterscheiden, ob mehrere Personen tatsächlich eigene Belege beitragen oder nur dieselbe Ausgangsinformation bestätigen. Widersprüchliche Befunde erhalten eine verantwortliche Person zur Klärung und bleiben bis zur Klärung im Beschluss als offene Punkte sichtbar.
Dabei muss die Projektleitung unterscheiden, weshalb Einschätzungen abweichen: Fehlendes Wissen verlangt Austausch, unklare Zuständigkeit dagegen Klärung. Wer Fehlerfolgen verantwortet, kann berechtigt strengere Anforderungen stellen als jemand, der Entlastung benötigt. Auch Verkaufsinteressen oder der Wunsch nach Projektfortschritt beeinflussen das Gespräch. Schweigen und unterschiedliche Empfehlungen sind daher noch kein Beleg für Gruppendruck oder einen Bias. Entscheidend ist, ob die Begründungen sichtbar werden und geprüft werden können.
| Gesprächsmoment | Mögliche Fehler | Gegenmaßnahmen |
|---|---|---|
| Vorführung | Positive Befunde gemeinsam aufwerten, Einwände vertagen. | Fehlende Varianten und Gegenbelege vorab benennen. Für KI und Alternativen gleiche Maßstäbe verwenden. |
| Nutzenplanung | Eine frühe Zahl durch gemeinsame Korrekturen scheinbar absichern. | Schätzungen eigenständig herleiten und Annahmen vergleichen, bevor Werte zusammengeführt werden. |
| Budgetempfehlung | Einigkeit mit einer vollständigen Wissensbasis verwechseln. | Besondere Beobachtungen vor der Bewertung sammeln und widersprechende Befunde gezielt prüfen. |
Wie Teams ihre Entscheidung gegenprüfen können
Zurück zur Eingangsfrage: Für die beschriebene Vorführung passt Antwort A am besten. Der Einwand wurde eingebracht, seine Klärung erhält aber weniger Gewicht als die positiven Befunde, die die weitere Planung bereits tragen. Deshalb sollte die Runde unterschiedliche Belegmaßstäbe und damit einen möglichen Bestätigungsfehler prüfen. Für B müsste ein früher Zahlenwert die Bewertung prägen, bei C wäre besonderes Wissen noch nicht in die Diskussion eingeflossen. Diese beiden Mechanismen werden erst in den weiteren Gesprächsmomenten sichtbar. Begeisterung für KI könnte die Bewertung begünstigen, erklärt für sich aber noch nicht, weshalb die Runde den Einwand zurückstellt.
Für den nächsten Versuch hält das Team fest, welche Varianten untersucht, welche Nutzenannahmen geprüft und welche Betriebserfahrungen einbezogen werden. Die Prüftiefe richtet sich danach, welche Folgen die anstehende Entscheidung hat und wie leicht sie sich zurücknehmen lässt: Ein begrenzter Lernversuch braucht weniger Absicherung als eine operative Einführung oder längerfristige Anbieterbindung. Nicht alles muss vorab beantwortet sein, aber Lernziel und Zuständigkeiten müssen feststehen. Die operative Einführung bleibt zunächst offen.
Die gemeinsame Empfehlung sollte aus nachvollziehbarer Gegenprüfung entstehen. Dazu gehören eigenständige Erstbewertungen, offengelegte Annahmen und bislang nicht geteiltes Wissen. Wer mögliche Gegenbelege prüft und wie sie in den Beschluss eingehen, wird vorab festgelegt.
Dieser Einstieg eröffnet den fachlichen Lernpfad zu psychologischen Verzerrungen bei KI-Vorhaben. Ähnliche problematische Empfehlungen können aber unterschiedliche Ursachen haben und verlangen entsprechend andere Gegenprüfungen. Der inzwischen veröffentlichte Beitrag „Bias ist nicht gleich Bias“ ordnet dafür fünf übergreifende Fehlerbereiche ein. Weitere geplante Detailartikel vertiefen einzelne Mechanismen.
Zusammenfassung
Ein intelligentes Team kann zu einer verzerrten Empfehlung gelangen, wenn seine Mitglieder Informationen einseitig gewichten oder gemeinsame Zustimmung als zusätzliche Absicherung behandeln, obwohl die Grundlage ungeprüft bleibt. Informationslücken und berechtigter Dissens müssen davon unterschieden werden. Gegenmaßnahmen setzen am gemeinsamen Entscheidungsablauf an:
- Gegenbelege und Vergleichsmaßstäbe vor der nächsten Vorführung festhalten.
- Schätzungen eigenständig herleiten und ihre Annahmen offen vergleichen.
- Besonderes Wissen und berechtigte Einwände vor der Festlegung zusammentragen.
Die praktische Leitfrage lautet: Welcher Befund würde unsere Empfehlung ändern, und haben wir die nächste Prüfung so gestaltet, dass er gefunden und berücksichtigt werden kann?
Einseitige Zusammenfassung herunterladen (PDF · 1 Seite)
Quellen
[1] Çalıklı, G., Bener, A. B. (2013). Influence of confirmation biases of developers on software quality: an empirical study. Software Quality Journal 21, 377–416. https://doi.org/10.1007/s11219-012-9180-0
[2] Stephani, H., Weibel, T., Rösch, R., Moghiseh, A. (2023). Challenges and approaches when realizing online surface inspection systems with deep learning algorithms. Discover Data 1, 3. https://doi.org/10.1007/s44248-023-00004-w
[3] Carvalho, P., Lafou, M., Durupt, A., Leblanc, A., Grandvalet, Y. (2024). Detecting visual anomalies in an industrial environment: Unsupervised methods put to the test on the AutoVI dataset. Computers in Industry 163, 104151. https://doi.org/10.1016/j.compind.2024.104151
[4] Lord, C. G., Lepper, M. R., Preston, E. (1984). Considering the opposite: A corrective strategy for social judgment. Journal of Personality and Social Psychology 47(6), 1231–1243. https://doi.org/10.1037/0022-3514.47.6.1231 · Abstract
[5] Mussweiler, T., Strack, F., Pfeiffer, T. (2000). Overcoming the inevitable anchoring effect: Considering the opposite compensates for selective accessibility. Personality and Social Psychology Bulletin 26(9), 1142–1150. https://doi.org/10.1177/01461672002611010
[6] Google for Developers. Classification: Accuracy, recall, precision, and related metrics. Geprüft am 01.11.2026. Originalquelle.
[7] Stasser, G., Titus, W. (1985). Pooling of unshared information in group decision making: Biased information sampling during discussion. Journal of Personality and Social Psychology 48(6), 1467–1478. https://doi.org/10.1037/0022-3514.48.6.1467 · Volltext
[8] Tjolleng, A., Chang, J., Park, J., Lee, W., Cha, M., Park, J., Jung, K. (2023). Development of a human-friendly visual inspection method for painted vehicle bodies. Applied Ergonomics 106, 103911. https://doi.org/10.1016/j.apergo.2022.103911
[9] Buser, D., Schwaninger, A., Sauer, J., Sterchi, Y. (2023). Time on task and task load in visual inspection: A four-month field study with X-ray baggage screeners. Applied Ergonomics 111, 103995. https://doi.org/10.1016/j.apergo.2023.103995 · Abstract
Quellenstand: 26.–27.10.2026, Kennzahlenreferenz ergänzt und geprüft am 01.11.2026. Der Leitfall sowie seine Gesprächs- und Prüfbeispiele sind fiktiv. Die gesondert gekennzeichnete eigene Erfahrung stammt aus einem realen ML-Projekt und ist kein Teil des Leitfalls. Es werden keine empirischen Leistungs-, Kosten- oder Nutzenwerte des Unternehmens behauptet. Maßnahmen ohne gesonderten Wirksamkeitsbeleg sind fachlich begründete Vorschläge für den Fall.
Fachlich passende Artikel
Weiter im Facharchiv
Zur Kategorie „Entscheidungsarchitektur“ · Alle Fachbeiträge · Alle Themenbereiche